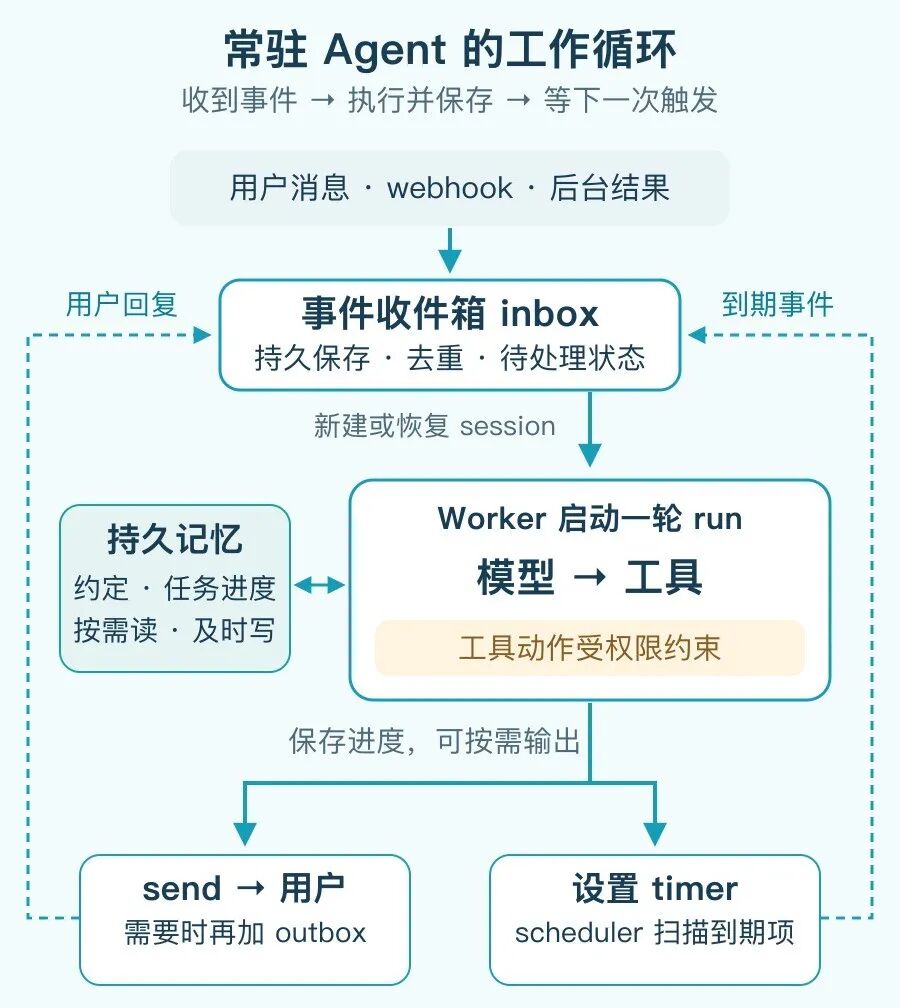
Anthropic 给的 always-on agents 参考架构,把「进程常驻」换成「任务持续推进」:Inbox 记事件、Timer 排未来、Memory 存进度、Permissions 等确认、Outbox 管发送。

给 Agent 一个任务,它可以查资料、调工具、写代码。但今天没做完,明天能不能自己接着做?测试结果隔夜返回,能不能自动继续?用户暂时没有回复,Agent 能不能安静等待,等到真正需要决定时再开口?
Anthropic 分享的一套 always-on agents 参考架构,解决的不是“如何让模型一直运行”,而是“如何让一件事持续推进”。一项任务可以持续几天,但每次执行只需要很短;两次执行之间的等待、触发、记忆和权限,都交给系统负责。
这套思路对 Coding Agent、Personal Agent 和企业自动化都适用:让进程可以结束,让任务不会丢失。
7×24 在线,不等于 7×24 占着进程
常驻 Agent 最容易踩的坑,是把持续工作理解成一个永不退出的循环。实际任务中,大部分时间都在等待:等 CI 结果、等用户确认、等定时器到点、等外部系统回调。让 worker 一直挂在那里,既浪费资源,也让故障恢复变得困难。
更合理的模型是:
- run:一次具体的执行,包含模型判断和工具调用;
- session:跨多轮 run 保存消息、工具记录和任务上下文;
- event:触发下一轮 run 的事件,例如新消息、测试回调或定时器到期。
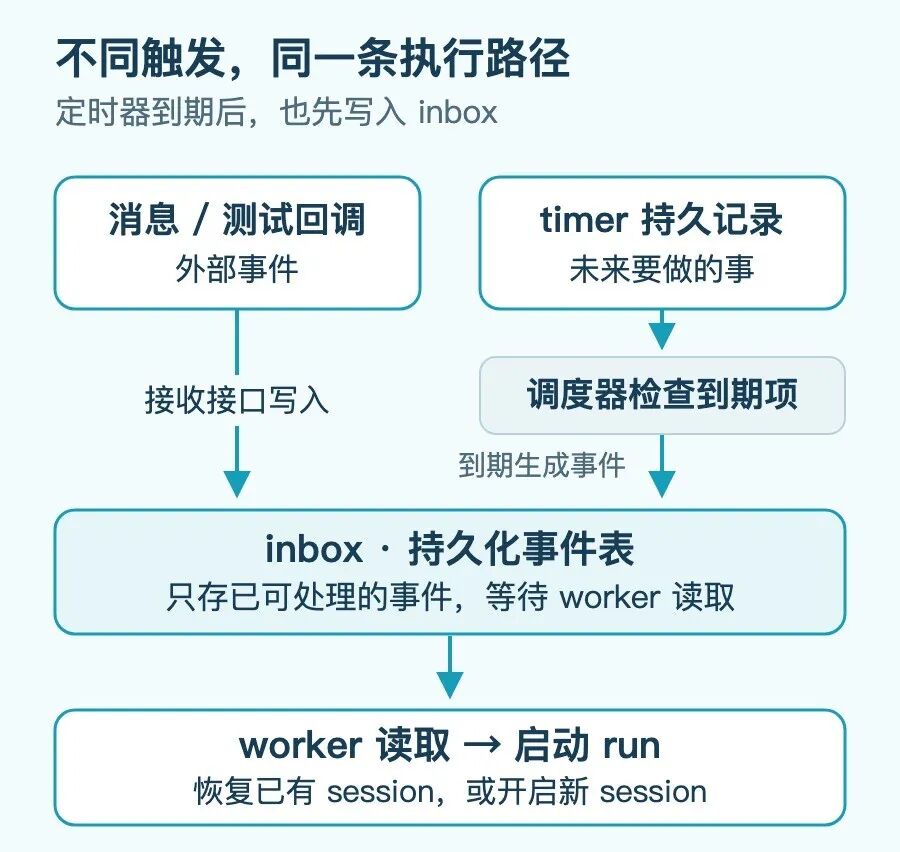
一轮执行完成后,进程可以退出。下一条事件到来时,系统恢复已有 session 或创建新的 session。所谓“在线”,指的是任务有持续跟进的入口,而不是某个进程永远不睡觉。
模型循环之外的五类系统职责
每轮 run 内部仍然是熟悉的模型与工具循环:判断下一步、调用工具、查看结果、继续工作。但要让任务跨越数小时和数天,真正重要的是循环之外的五类职责。
Inbox:先记录事件,再启动执行
所有外部事件先写入持久化 inbox 表,再快速返回“已收到”,由后台 worker 读取待处理事件。这样即使 worker 中途退出,后续实例仍能找到未完成记录。
一个最小实现可以只有一张表、一个 HTTP 接口和一个后台 worker。事件带唯一 ID,用于去重;同一用户连续发来的补充消息,可以在入队后合并成一轮处理。
原型阶段可以从“一个用户一个 inbox,同一个 inbox 同时只有一个活跃 worker”开始,先保证状态更新有明确顺序。消息到达时是并入当前 run、留到下一轮还是中断重来,应按交互场景决定。
Timer:把未来安排变成事件
“两小时后再检查一次”不能靠 worker 进程阻塞等待。系统应把未来安排持久化到 timer 表,由调度器定期检查,到期后更新 timer 并向 inbox 写入一个事件。
一次性 timer 标记为已触发,周期 timer 更新下一次执行时间。到期只负责入队,真正执行仍由统一的 worker 流程完成。这样定时任务和用户消息可以走同一条执行链,不需要额外维护一套 Agent 运行逻辑。
Timer 还要处理可靠性问题:如果标记完成成功,但事件写入 inbox 失败,下一次跟进就会消失。两张表在同一个数据库时,可以用事务保证一致;如果使用不同存储,则需要可重试投递和事件去重。
Memory:把进度保存到本轮之外
继续执行时,系统需要知道上次做到了哪里。直接沿用 session 能带回消息和工具调用,但上下文有上限,压缩历史或创建新 session 又可能丢失关键细节。
更稳妥的做法是把重要进度及时写入持久化记忆,并按类型处理:
| 信息类型 | 保存方式 | 读取策略 |
|---|---|---|
| 外部系统状态 | 保存引用和查询条件 | 每轮执行前重新查询 |
| 任务目标与约定 | 保存结构化记录 | 每轮按任务加载 |
| 工作产物 | 文件、提交、报告或测试结果 | 需要时读取最新版本 |
| 长期经验 | 归纳后的规则和偏好 | 按角色或项目加载 |
一句“测试通过”远远不够,还要记录哪个提交、哪次测试、哪个环境通过。否则 Agent 很容易把单元测试通过误判为功能已完成,而用户流程仍然存在问题。
记忆和工作产物的寿命必须长于临时 worker。文件目录、数据库和对象存储都可以作为实现,但不能把唯一进度留在某个容器的临时文件系统中。
Permissions:等待用户确认也是任务状态
Agent 准备推送代码,但用户不在线时,不能让 worker 一直等待。系统可以保存 session 和未完成的工具调用,展示待确认问题,结束本轮执行。
用户第二天回复后,答案作为事件进入 inbox,触发新的 run,恢复对应 session。保存的记录必须能回答三个问题:这个确认属于哪个任务、对应哪个工具调用、待执行对象是否仍然是同一个版本。
Claude Code 的 hooks 体系提供了类似的 defer 机制:PreToolUse 可以在非交互模式下暂缓调用,由外层应用收集用户回复后恢复 session。它有适用边界,例如当前回合要求只有一个工具调用,交互模式或多个工具并行调用并不适用。
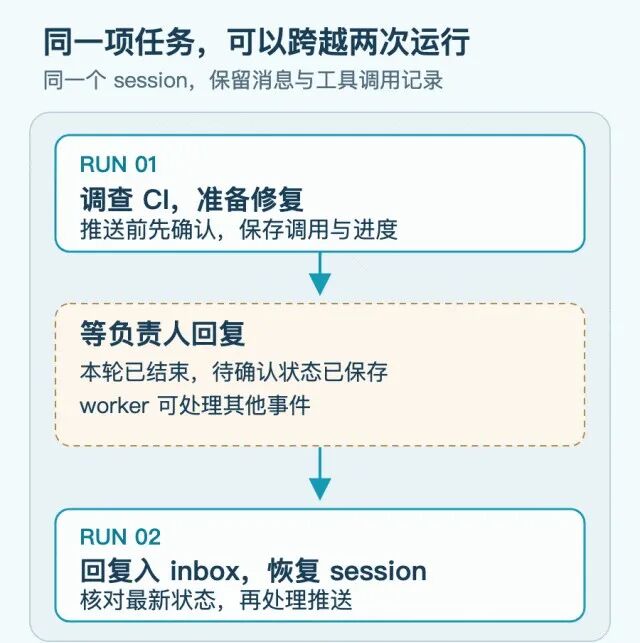
权限还要区分“需要确认”和“可自动执行”。无人值守模式下,分类器可以拦截高风险动作,凭证则由代理在执行环境外注入,避免把真实令牌交给 Agent。分类器并不完美,工具权限仍然需要最小化,恢复执行前也要重新核对分支、文件版本和用户目标。
Outbox:把消息发送和任务执行分开
Agent 修复完成后,最后一步是让用户知道结果。一次 run 的结束可以有三种状态:发送消息、安静结束、暂缓工具调用并询问用户。
如果每次定时检查都发送“暂无新进展”,系统很快会变成噪声源。没有新结果时可以静默;任务完成、需要决定或出现异常时才通知。
简单场景可以使用一个 send 工具直接发消息。需要控制发送节奏、从发送失败中恢复时,再引入 outbox:Agent 把待发送消息写入独立表,由 dispatcher 负责投递。这样消息发送失败只需要重试通知,不必重新执行一遍已经完成的代码修复。
异步任务必须有回调和幂等性
以代码修复为例,Agent 提交测试后可以保存测试任务 ID,结束本轮执行。CI 完成后把结果作为事件写入 inbox,新的 worker 再恢复 session 继续工作。
但恢复时不能盲目相信本地状态。等待期间用户可能改变修复目标,分支可能已经更新,外部测试也可能已经成功,只是回执在网络中丢失。系统应在恢复前查询外部状态,并用幂等键避免重复提交。
这条规则适用于支付、部署、发消息和数据修改等所有有副作用的动作:事件去重只能保证本地事件不重复处理,不能保证外部操作只发生一次。真正可靠的系统,需要外部查询、幂等键和可回滚动作一起工作。
如何把这套架构落到现有项目
不需要一开始拆成五套微服务。一个应用加一套现有数据库就足够搭出第一版:
- 用 inbox 表记录外部事件、状态和唯一 ID。
- 用 worker 处理事件,每个用户或项目保持单活跃执行者。
- 用 session 和任务表保存上下文、进度、产物和审批状态。
- 用 timer 表安排未来事件,调度器只负责到期入队。
- 用 outbox 表管理通知和可重试投递。
- 为外部副作用补上幂等键、回执查询和人工接管。
这套设计的核心不是增加更多 Agent,而是让每一轮执行都留下足够信息,并为下一轮安排好触发条件。任务可以暂停,进程可以退出,系统仍然知道下一步从哪里继续。
Anthropic 的常驻 Agent 架构更像一套运行时方法论,而不是某个固定产品。国内团队如果希望通过 API 接入 Claude 等模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道,但 inbox、timer、memory、permissions 和 outbox 仍需按自身业务设计。
常见问题
7×24 在线 Agent 是否需要常驻进程?
不需要。让任务持续的是持久化事件、定时器、会话和工作产物;每轮 run 完成后,worker 可以退出,下一条事件到来时再恢复。
Inbox 和消息队列有什么区别?
Inbox 更强调面向任务的持久化事件和状态管理。它可以建立在数据库表上,并保存去重、合并、处理状态和关联 session 等信息。
为什么 Timer 到期后还要写入 Inbox?
这样定时触发和用户消息、外部回调可以走同一套处理流程,避免为每一种触发方式单独实现 Agent 运行逻辑。
Memory 只保存摘要够吗?
不够。摘要适合长期经验,但任务进度还需要提交、测试、工单、版本和外部系统引用等可验证产物。
延迟工具调用有什么限制?
需要保存待执行工具、参数、任务和版本上下文。某些 hooks 机制只适用于单工具调用和非交互模式,不能默认覆盖所有并行执行场景。
国内团队如何实现这类常驻 Agent?
可以通过 Code80 等渠道接入模型,但应先实现事件持久化、任务状态、权限确认、幂等副作用和通知重试,再扩大 Agent 的自动化范围。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议