优步重构了Uber Eats搜索管道"的主要部分,使端到端搜索延迟降低了50%。这些改进涵盖了检索、特征填充(feature hydration)、排序、广告、展示和基础设施等多个环节,同时优步还引入了智能体编码(agentic coding)工作流,以识别、基准测试并验证额外的优化方案。
这项工作始于对主要延迟指标的调整。优步不再仅仅关注后端API的响应时间,而是开始测量“首屏渲染完成时间”(Above-the-Fold completion)",即从发起请求到首屏结果连同图片完整渲染出来的时间。通过服务端缓存实现分页,缩短了初始响应时间。同时,异步渲染机制允许并发处理结果项。优步报告称,这些改进使首屏渲染延迟降低了200毫秒以上。
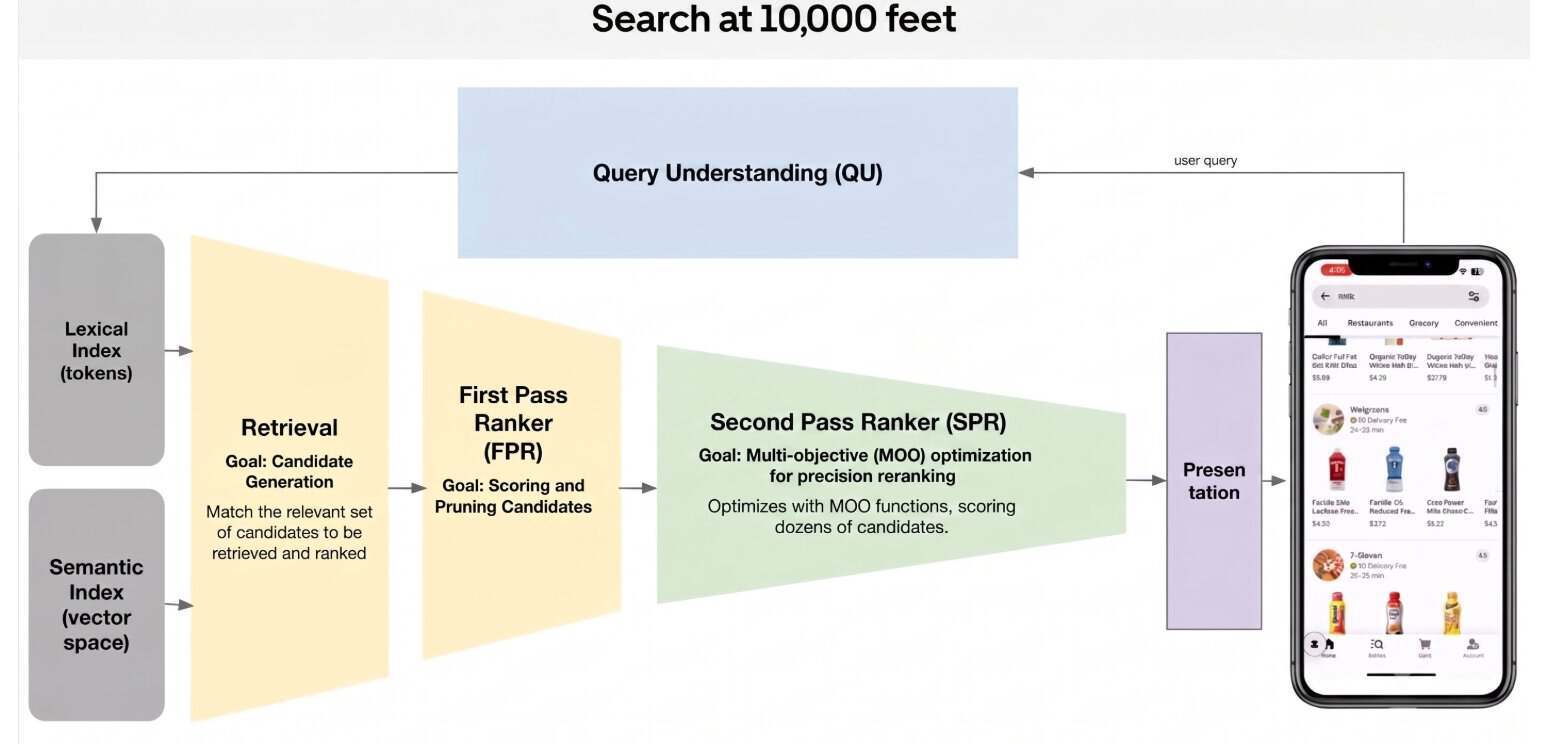
Uber Eats搜索管道的架构图(来源:优步博客文章")
优步发现,在排序之前有数万个候选项被填充了特征数据,而其中许多最终会被丢弃,借助该发现他们大幅减少了检索阶段的工作量。移除低价值的检索策略节省了约120毫秒,引入产品级嵌入(embeddings)使数据查询次数减少了100倍以上,又节省了50毫秒。将排序阶段的特征填充与展示数据分离,使延迟降低了100毫秒以上。此外,移除不必要的依赖项和请求对冲(request hedging)分别贡献了35毫秒和40毫秒的延迟缩减。广告链路也经过了重新设计,采用了面向列(column-oriented)的竞价数据、内存访问并减少了序列化操作,使延迟降低了约130毫秒。在基础设施层面,其他改进还包括并行编码、使用更小的嵌入向量、优化连接管理,以及调整Go语言的数据结构以降低垃圾回收(GC)的开销。
这一系列工作引起了公开讨论该项目的工程师们的广泛关注。Anubhooti Nagar"将这一性能挑战总结为":
与其说是把现有的事情做得更快,不如说是减少不必要的工作,并避免无谓的等待。
Nagar还特别强调了优步的:
测量、识别、修复、验证(Measure, Identify, Fix, Validate)循环,认为这是持续性能优化的典范。
Pratik Dhanave"强调,这一成果源于渐进式的增量优化,而非单一的系统架构变更。他将其描述为",“背后并没有某个单一的宏大创意,而是贯穿整个技术栈的一系列审慎决策”。他以延迟指标测量、特征填充、广告链路以及基础设施等方面的改动作为例证。
Vidya Pandey"将这些改动提炼为三大原则:减少工作量、尽早开始处理、移除不必要的依赖。Pandey还将优步计划采用的微批处理(microbatching)"方法与AI系统中用于减少处理阶段之间同步等待的技术联系了起来。
此次改进建立在优步现有搜索平台的基础之上。此前的资料显示,该平台采用了Apache Lucene、基于Spark的索引、基于Kafka的流式更新以及分布式服务层。InfoQ此前对优步搜索架构的报道",也为该平台早期的索引和查询执行工作提供了更多背景信息。
目前,优步正在探索端到端微批处理、基于产品的检索、零遍历排序(Zero Pass Ranking)以及HTTP多部分流式传输(multipart streaming)。该公司报告称,早期基于产品的检索测试已使p99延迟降低了50%以上。这些计划中的改动允许各个处理阶段相互重叠,从而无需等待前序阶段全部完成。
查看英文原文:Uber Eats Rebuilds Search Pipeline to Cut End-to-End Latency by 50%"