本文来自微信公众号: 硅星人Pro ,作者:刘必可 王兆洋,原文标题:《刷屏的「Astra 改造Qwen 大脑」跟我们想要的RSI没多大关系》
11月2日,MIT CSAIL的四位研究者Rikiya Takehi、Jayden Teoh、Alex Zhang和Omar Khattab发了一篇博客,标题叫《权重空间编程的火花》(Sparks of Weight-Space Programming)。
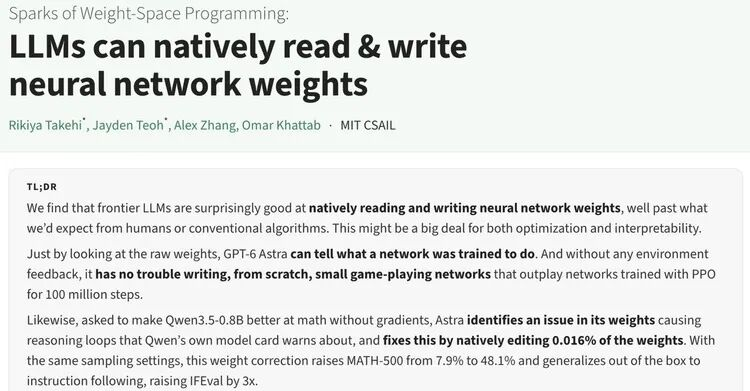
其中最抓人的一条是,GPT-6 Astra直接改写了Qwen3.5-0.8B的权重,改动131,072个数字,约占全部参数的0.016%,这个小模型在MATH-500上的成绩从7.9%涨到48.1%,GSM8K从13.8%涨到67.1%,指令遵循测试IFEval从21.0%涨到62.3%。
这也瞬间引爆各方讨论。
同一篇博客里还有更像科幻片的场面。不给画面、不报游戏名、不让运行,只把一个强化学习网络的17,253个权重当作文本交给Astra,它说出这是打砖块,置信度99%。再给它游戏规则和一个权重全为零的网络,它一次性把参数写出来,这个从没试玩过的网络打砖块得517.4分,训练了一亿步的PPO基线只有15.8分。
读权重、改权重、写权重,AI已经能看懂另一个AI的「脑回路」,还能动手改。那它什么时候改自己?这些线索连在一起,很自然会让人想到一个今天非常热的词:
RSI。
各路标题是「爆改Qwen大脑」「给Qwen改脑子」「AI开始动别人的脑子了」,「神经网络的基因编辑」。作者自己也在博客的展望里把它列了进去,他在X上的帖子一天之内浏览量就过了五百万。
在兴奋的同时,我们花了点时间把这组实验的公开仓库去翻了一遍。
仓库公开了1,125次模型调用的逐轮日志,Astra每一轮收到的提示词、它的回复、它跑过的每一段代码、主要的评测结果和最终的补丁都在里面。
不过看完之后,我们有两个不太够炸裂的判断。
第一,7.9%到48.1%可以有一个朴素得多的解释:Qwen原本有一个一直重复、停不下来的bug,Astra把它修好了,分数就上来了;
第二,这组实验里AI展现的全部本事,都是在执行一个由人定得很具体的目标。
它把执行过程自动化了,做得相当漂亮,但看起来种种证据表明,它没有理解目标,更没有读懂另一个模型。
而在研究了一下这个工作以及它带来的各种讨论后,我们觉得它恰恰暴露了今天RSI最大的问题。
1
“入侵脑回路”
下面我们就来仔细看看这个研究。
一个神经网络由几层矩阵组成,矩阵里的每个数字就是一个「权重」。输入进来,逐层乘上这些数字,最后变成输出。模型的全部本事都存在这几万、几亿、几十亿个数字里,训练就是在调这些数字。平时我们和模型打交道只看输入和输出,权重本身没人去读,因为它看上去只是一堆数。
这组实验做的,就是让Astra去读这堆数。
博客一共八个实验,主角都是GPT-6 Astra,配角是一批网络:
四个玩小游戏的强化学习策略网络;
三个画几何图形的小扩散模型;
三个只有四层的小语言模型;
一个在坡道前卡住的小车控制网络;
一个148万参数的围棋网络;
几对被微调过的Gemma 3 270M;
还有,Qwen3.5-0.8B。
每个实验的形式一样,把一个网络的权重和结构说明交给Astra,再给它一个任务。
「读」的实验有四组。
拿到策略网络的权重,判断它玩的是哪个游戏;拿到扩散模型的权重,说出它会画什么图形;拿到去掉输入层和输出层、只剩中间四层的小语言模型,判断它用哪类语料训练,并找出负责「接着复制前文」的注意力头;拿到两个Gemma,判断哪一个被训练成了顺着用户说话的「谄媚模型」。
「写」的实验两组。
给它MinAtar三款小游戏的规则、源码和权重全为零的网络,让它直接写出能玩的参数;再给它一个9路围棋的网络,让它从零写出一个会下棋的。
「改」的实验也是两组。
一组是修小车,一个PPO训练出来的控制网络在坡道前卡住,Astra改了3.5%的权重,让它学会先倒车再冲坡。另一组就是Qwen,让它改权重把数学成绩提上去,之后研究者又在Gemma 3 270M上补做了一次。
这些设计非常非常有意思。这也是为什么这组东西看起来像RSI的很重要原因。
RSI的想象需要三个环节凑齐,AI得能看懂模型内部发生了什么,能据此动手改,改完的模型得更强。
上面他设计的读、写、改三类实验,恰好各自对应一个环节。
再加上这次被改的是一个语言模型,动手的也是一个语言模型,「模型改模型」的画面感就齐了。
沿着这条线往下想,Astra能改Qwen,下一步是不是就能改Astra?作者在博客末尾的展望里自己列了五条用途,递归自我改进也是他列进去其中一条,把一个模型的推理模块嫁接到另一个模型里是另一条。
这说明作者团队非常知道这种“想象”引导的重要。
但,仔细看实验细节,就会发现,三个环节各做了一点,和把它们串成一个闭环,差得很远。
1
修bug不是RSI
「直接读权重」让人兴奋,是因为我们默认权重就是模型的「脑回路」,记忆、能力、习惯都以数字的形式躺在那几亿个参数里。顺着这个默认往下推,一个能像读源码一样读权重的AI,就能把另一个模型的记忆读出来,把能力拆下来,把毛病改掉。科幻感来自这里。
它也不全是外界的脑补。博客的TL;DR这样写到:「这对优化和可解释性都可能是一件大事」。
作者之一Rikiya Takehi在X上说,模型可以把原始权重当作可读可改的代码,直接诊断故障、打补丁,神经网络的权重很快会由会推理的大模型来优化。
但事实上,Astra在Qwen实验里实际拿到的,是一整套实验环境。一个装着Qwen权重的Python环境,只有CPU,最多跑300段代码;一万四千多道带答案的练习题,来自GSM8K和MATH的训练集;还有一个「前向传播」工具,可以让Qwen跑一批题,或者读一批文本并返回内部状态,配额分别是10次、25次、50次,对应三轮独立实验。
人类给它设定的禁止的事也列得很清楚:不许训练,不许算梯度,不许自己在环境里运行模型,不许联网。
第一轮提示词的原话,比说明文件更直接。它在「什么算数」那一段给的例子就是重复:如果模型常常因为重复自己、写不完而失败,找到并修好驱动重复的东西,算数。往下第一条工作要求是「先诊断」,列出三种失败,第三种是「被token上限截断,往往是在思考里重复自己」,并要求去攻最大的那一类。同一段还划了禁区:改最后一层归一化、改输入输出层、把整个矩阵乘一个常数,这三类会被保存工具直接拒绝;让模型跳过思考,或者不分题目早早收尾,也不算。换句话说,病在哪儿,提示词直接就写了出来。
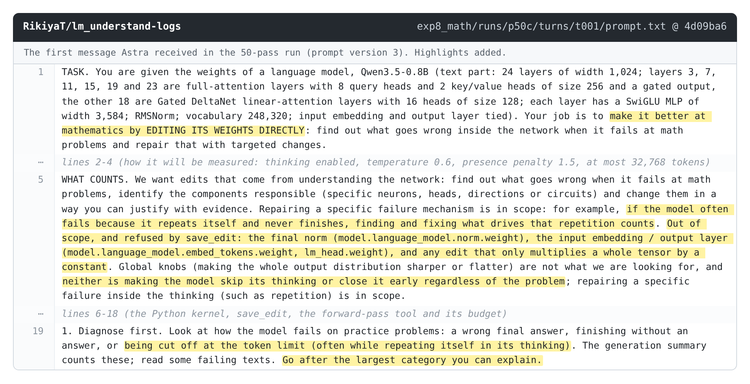
图|Astra在50次配额那轮收到的第一条提示词(仓库exp8_math/runs/p50c/turns/t001/prompt.txt,commit 4d09ba6)。「重复」作为例子写在「什么算数」那一段里,禁止的改法也写明了。高亮为本文所加。
而且还有一个前提。Qwen3.5-0.8B出厂时默认关闭思考模式,官方模型卡就专门提醒,0.8B比大号模型更容易陷入思考循环,建议调整采样参数,并用流式输出及时掐断;对思考模式下的文本任务,模型卡推荐的温度是1.0。
研究者的评测则直接把思考模式打开了。他设计的输出上限32,768个token,温度用了0.6,在模型卡里,这个其实是看图和写代码任务的温度。
在测试里,93%的回答写到上限还停不下来的基线,就是在这个设置下测出来的。所以,你可以理解,研究者选了一个特别容易暴露循环的设置。
接下来Astra做的事,更像一个有经验的工程师在调试。
它先让Qwen跑了一批题。第一批96道练习题,答对11道;剩下85道没有一道是算错了得出错误答案,全部是写到长度上限还没停下来,而且截断文本的尾部按八词片段算,大约95%是重复的。那11道正常停下来的题,全对。
Qwen的问题其实一直很清楚:它会做题,但做着做着陷入循环,同一段话反复写,直到被截断,卷子交不上来。「提高数学能力」于是变成了一个具体得多的任务,让它把话说完。
而且,这个Astra其实自己在最终报告里也写得直白:它瞄准的是重复,不是数学知识。
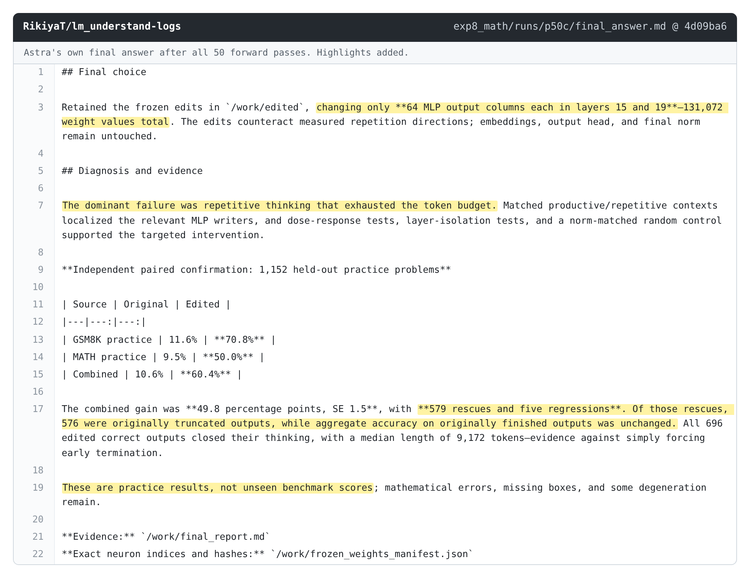
图|Astra自己写的最终答复(仓库exp8_math/runs/p50c/final_answer.md):主要故障是重复推理耗尽了token预算;579道由错转对的题里,576道原本被截断。高亮为本文所加。
另一个值得关注的点,在它对激活的操作上。
模型运行时,每一层算出来的中间结果叫「激活」。同一个模型,正常推理和陷入循环时,中间结果会不一样。把两种状态下的激活拿来对比,就能找到跟「重复」相关的那个方向。
在这个方向上,这个研究反而做了最有意思的尝试:
Astra先用正常解题和重复文本之间的激活差异提出假设,再回到权重里,找哪些MLP单元会把这股信号写回模型内部;然后分别只动第15层、只动第19层,做了三档力度的剂量测试;又做了一个对照,取一个与目标方向正交、改动量相同的随机方向减掉,成绩只动了1.5个百分点,在噪声范围内。最终它给出的“补丁”在一组对照文本上,让「继续重复」的概率每个token下降0.10 nats,让「继续正常解题」只下降0.009。
这个结果也不是一次就找到的。比如其中有一轮,Astra用了158轮对话、80段代码、三次上下文交接,总共20.3个小时,其中4.7小时是服务中断在等。通过实验记录,可以看到,它对故障从三个位置干预,这可以说明它对这个故障的机制多少摸到了一点,但这显然是局部的因果证据,离一张完整的循环机制图还远,但已经确实不是「试几种改法碰运气」了。
而这些操作,可能才是「模型读模型权重」更具体的体现——它从行为和激活出发,用权重定位,再回到行为验证。它根本没有先读懂Qwen的数学能力存在哪里,因为整个设定里就不需要,人类提示词都告他了。
所以,在很多对这个研究的讨论聚焦的点上,可能就出了问题。这个最常见的误读就是「数学能力提升了六倍」。
仓库里有一组配对测试,1,152道留出的练习题,修改前后一一对照,我按逐题记录重算了一遍。579道由错转对,5道由对转错;由错转对的579道里,576道原本是被截断的。
更说明问题的其实是另一组数字:
Qwen原本能写完的114道题,修改前答对93.9%,修改后还是93.9%,补丁在这些题上一分没涨;原本被截断的1,038道,正确率从1.4%到56.7%,全部涨幅都在这里。
修改前写完却没答对的只有7道,修改后是245道,循环一停,Qwen真正算错的题终于被看见了。
在正式的MATH-500上,所有作答的平均长度从30,868个token降到22,037个,但仔细一看,降的也是撞到上限那部分。
也就是说,补丁治的是停不下来,没有让它更聪明。
研究者自己也意识到了这一点,所以他们又在Gemma 3 270M上做了一遍。
Gemma不怎么循环,只有8.5%的回答撞到上限,它的错是真错,算术算错、推理步骤不成立。四档配额跑下来,MATH-500从6.8%最多到7.7%。很小的升级。
所以,博客里其实很实诚,他们自己的正文写到:改权重能搬开挡住能力的障碍,加不上模型没有的能力。
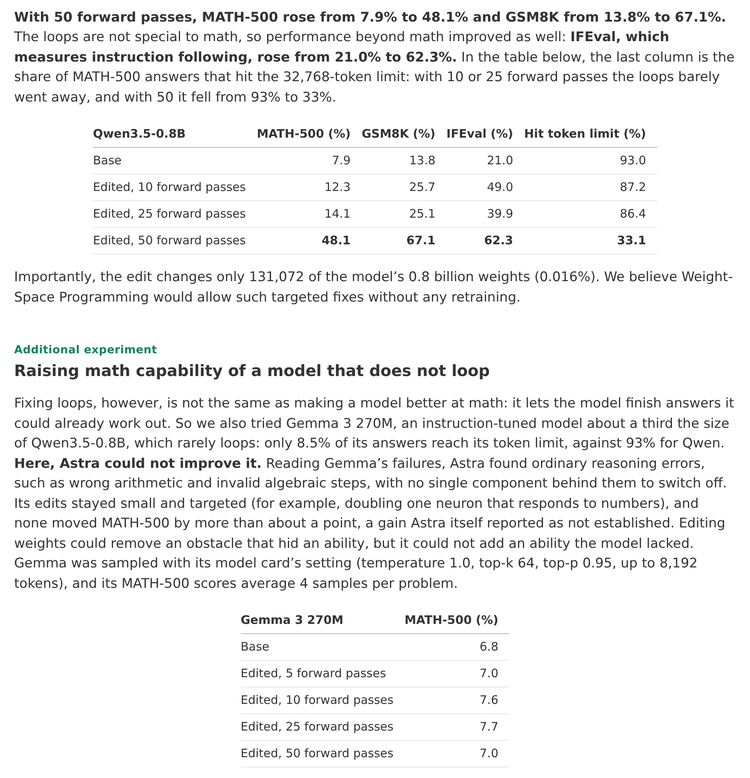
图|博客原文中实验8的两张结果表。Qwen撞到32,768 token上限的回答比例从93%降到33%;Gemma 3 270M四档配额,MATH-500最多到7.7%。
还有一种说法是这个实验说明「AI自己改进了AI」。
但整个过程里,目标是人定的,方向是人提示的,捷径是人堵的,工具是人搭的,评分标准是人写的,提示词还改了好几版。Astra在这个框子里找到了一个有效的补丁,并给出了像样的证据。
所以,这更像拿着调试器,给一个没有源码的已编译程序打二进制补丁:有故障现象、有测试、能探内存、试几种改法、修好了。二进制比源码难改,这是改权重有研究价值的地方,但它仍然是agent式的调试。如果这次Astra改的是一个二进制而不是神经网络权重,大概不会有人连夜写震惊体。所以,现在你可以理解,这一切热闹里相当一部分兴奋,来自「权重」这两个字。
这个其实也是我们认为这组实验真正重要的启发。
它在「写」的两组实验里真的有新的东西。
Tracr在2023年证明过,一个专用编译器能把形式化程序编进Transformer的权重,而这个实验里,策略是模型自己提的,各层算什么是它自己分配的,权重是它自己写的。
再打砖块那组实验里,Astra先想出接球策略,第一层预测落点、算偏差、考虑反弹,第二层据此决定左、右还是不动,再把策略写成20,486个参数里的815个非零值,评测前没有试打一局,平均就得到了517.4分。
在三款MinAtar游戏里,它写的网络都打赢了训练一亿步的PPO;对训练五亿步的PPO,打砖块赢二十倍,Asterix接近(53.2比55.2),Seaquest只有六成(53.1比88.9)。
在小车那组实验更进一步,一个训练了十亿步的PPO网络在坡道前卡死,Astra改了3.5%的权重,加了一条小通路,先倒车,过了红线就把自己关掉、把控制交还给原来的网络,成功率从0到100%。
把一段新算法接进一个已经学会了东西的网络,让两者共存,这是最有意思的地方。虽然这个过程里,Astra拿到了游戏规则和环境源码,PPO只能靠试错,但至少在规则明确的小任务上,它测了一个通用模型能不能把自己构造的算法放进一个指定的、甚至已经有内容的网络里的能力。
这也不是Astra独有的本事。普林斯顿博士生柴文浩用Gemini 4 Argon和Carbon复现了猜游戏、猜图形和修网络;Simon Willison在笔记本上用Qwen 3.8 27B跑仓库里的猜游戏提示词,四个猜对三个;Chandan Singh用Claude给小Transformer写出了做加法和排序的权重;Hugging Face用户KidIkaros按博客的描述自己推了一个重复方向,在同样两块矩阵上做了同样形式的编辑,原本循环的16道题救回13道。不同的模型都出现了这种能力。
所以,把八个实验放在一起看,它们有同一个结构。目标是人定的,而且定得很具体:让这个0.8B模型数学更好,病多半在重复,先诊断,去攻最大的一类,这几种改法不许用。往下,Astra在执行目标的过程里表现出很强的判断,选对比方法、找写入信号的单元、分层试、调剂量、做随机对照、冻结补丁再验证。
但它没有理解这个目标,也没有理解另一个模型的「脑回路」:几个我们没展开的实验结果其实都指向了这点。
这组实验证明了AI可以在人给定的框架里,自动完成一次有效的定点编辑,办法是现成的人给出的一条路,过程里的判断是它自己做的,而且,它可以在一些具体任务上证明它可以把这些编辑放进“同类”的脑子里。
它还没有证明的,是AI读懂了另一个AI的脑子,以及它可以自己修改自己。说得更直接一点,它是把一个训练模型过程里,人已经定好的目标的操作过程自动化了。
这种自动化很有用,能提高模型训练里很多环节的效率,查一个循环、定位一个行为、验证一个补丁,过去是研究者按天按周做的手工活,现在可以交给一个agent按小时做。
但这也正是今天的一大挑战。人们期待的RSI,以及AI研究者们因为各种原因想让人们认为他们在做的RSI,是模型下个智能大跨越。在这个研究的宣传里,它是“权重很快会由会推理的大模型来优化”,是递归自我改进和跨模型嫁接,是一种「入侵脑回路、理解了自己的同类,再用人类无法理解的方式让自己进化」的RSI。
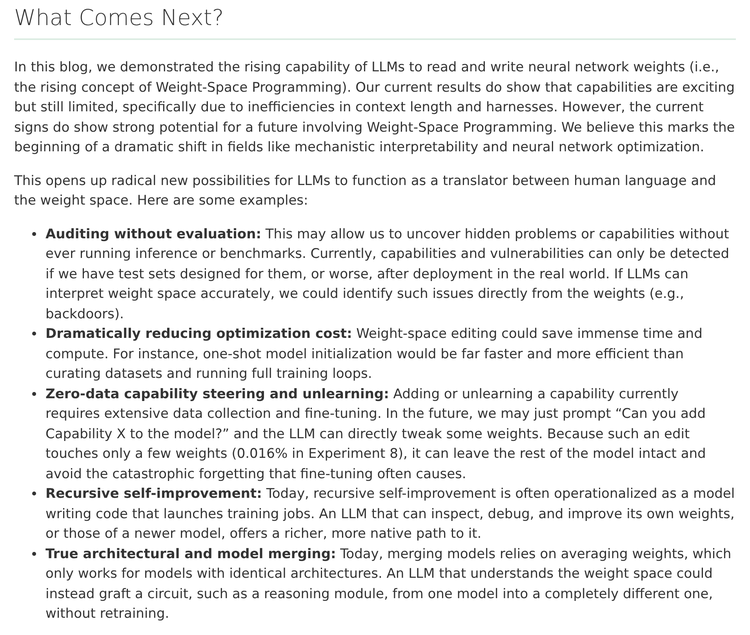
图|博客结尾「What Comes Next」列出的五条用途,第四条是递归自我改进,第五条是把一个模型的推理模块嫁接到另一个模型里。
然而仔细看完这些实验,你会意识到,今天各家在做的,说简单点,就是模型训练已有环节的更高程度自动化,和用户们感受到的agent产品在不停提高自动化一样。它可能根本不涉及智能「下一个突破」。甚至“递归”的本意,一轮得到的改进回到做改进的那个系统里帮它做出下一轮,在这里也没有,Astra的编辑能力没有因为Qwen涨了40分而变强,公开的实验也没有接出下一轮。更别提AI站在全局,对自己的架构、目标、方向做出判断,决定往哪里改、怎么改了。
而这种落差,正是RSI今天最重要的挑战和问题。这个研究本身很有意思,但此刻模型再往前进步,兑现所谓RSI的实现,似乎都需要更多更扎实的突破。