“Harness 就是包装纸,就是脚手架,就是提示工程”。这种论调在 Reddit 上每隔几天就会冒出来一次,甚至有人说“上下文工程根本不算研究问题”。但事实是,同一个权重文件,换一套 Harness,ARC-AGI 的成绩可以从 30% 直接飙到 95% 甚至 100%。
在 YC Paper Club 的 Harness Night 专场活动中,主持人VC Visiting Partner Francois Chaubard与几位论文作者,Prime Agent 作者 Seth Karten、OpenJarvis 作者 Jon Saad-Falcon、以及 QM 团队的 Josh France和 Regan Bell一起,围绕“为什么 Harness 比模型本身更重要”展开了三场演讲。连起来看是一条线:Seth 讲的是 Harness 该有什么样的表达力,Jon 讲的是这套东西能跑在哪种硬件边界内,Josh 和 Regan 讲的是把它放进真实组织后,权限、信任和协作会先出问题。本文基于该视频整理,经InfoQ编辑。
核心观点如下:
Seth Karten:回到第一性原理,搞清楚 Harness 到底是什么、该怎么建。
上下文分三层:L1 是模型权重,L2 是活跃上下文加 REPL,L3 是文件系统这类调度状态。Harness 的活就是在层与层之间做压缩、CRUD 和refinement,相当于缓存加垃圾回收。一个类比:裸 LLM 像图灵机,harness 像冯·诺依曼计算机,能在外部内存上读写,所以表达力强得多。评判标准是表达力。ReAct 那种固定循环模型已经原生会了,不用再显式强加;但压缩、Python REPL、编程式子Agent、状态访问、反馈机制必须给出来,删掉一个就是删掉一项它没法用别的方式完成的能力。具体设计:子Agent当持久子会话(可唤醒、可卸载)、任意两个Agent之间能直接发消息、借鉴 continual harness 做实时增删改查。评估要看长周期性能和平台期在哪。
Jon Saad-Falcon:个人 AI 不该困在云端。
现状的四个代价:按年算 API 费用能到数千甚至数万美元、最私人的数据要发到云端、是在"租智能"而不是拥有、能耗高出几个数量级。本地 LLM 只比前沿模型落后 6 到 12 个月,Qwen 3.8 27B 大致相当于 2025 年 8 月的 Claude 4.6 Opus,硬件加速器也在追上来。方案是用五个原语定义整个栈:界面、Agent逻辑、模型、推理引擎加硬件、工具记忆与学习,写成一份规格让整个栈可被优化。尽量不动 LLM,让云端 LLM 来诊断和门控本地配置,部署推理时不再产生云端成本。
Josh France和 Regan Bell:从三次迭代的踩坑里,反推出一个该长什么样的 Agent Harness。
QM是什么:给 YC 每位员工的类 Claw 助手,Slack 或 Web 都能用,有个人上下文、沙盒文件和定时任务,支持多人协作;覆盖邮件分类、法务财务流程、文档编辑、内部取数、启动内部 Web 应用。设计一:把 Agent 的大脑从沙盒里抽出来,全部集中到 Postgres,沙盒从“家”变成按需取用的资源,这个决定权交给 Agent 而不是Harness。设计二:Harness极简,核心只有三个工具(远程沙盒执行、对象存储读写、发布内部应用),记忆和定时任务那些都算临时补丁;同时允许 Agent 自己选运行时和沙盒提供商用 LLM 当评判会得“主角综合症”,只看得到大象的一部分,所以Human in the Loop仍重要;Agent 对自己的情境和社交情境理解都很差,特权信息容易泄漏,能放进大脑的信息实际上受限于权限系统有多好。解法是“磨砺工具”,给目标设预算,没到实际时间或 token消耗不许放弃,换来更好的研究输出。
为什么 Harness 比模型本身更重要
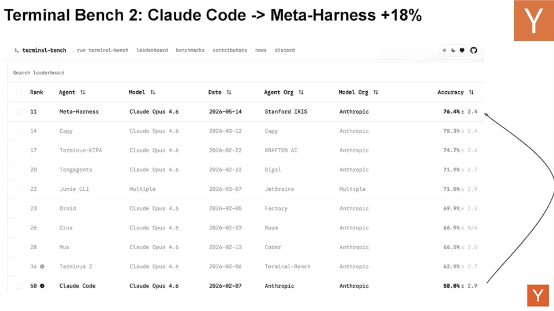
Francois Chaubard:为什么是 Harness?它不就是个包装、脚手架、提示工程吗?一条一个月前的 Reddit 帖子说:“不确定这种提示工程配不配得上顶级机器学习会议。”还有一条很经典的:“上下文工程不是研究问题”,Harness 长期以来被贬低为不入流的研究。但它带来了 18% 的提升,这是 Harness 1 和 Harness 2 的差距,也正如 Seth 会讲到的,这决定了 ARC-AGI 能不能跑通,所以它显然值得研究。
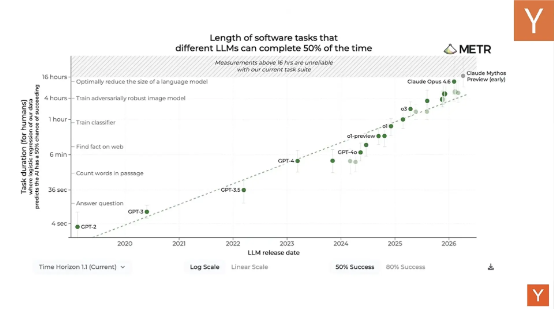
看这张经典的图,横轴是发布时间,纵轴是 Agent 能持续运行的时间,你会发现很多进步都归功于 Harness。我把它叫“静态 Harness 时代”,因为 Harness 本身不自我改进。而最近六个月,所有进展都集中在自我改进的 Harness 上。
这个图来自 Trajectory 的 CEO 的演示。他讲的是我们一直测的 perplexity,和智能有一定相关性,所以我们不断把智能往上推,却没有很好利用测试时经验。我们在新领域产生大量测试时经验,但没有快速适应。早就知道,增加在线样本时,怎么真正从 batch size 为 1 学习?没有这种结构。ICL 在 40 到 50 个样本之后就饱和,验证集上不再提升,然后要上小秩 LoRA、大秩 LoRA、SFT。居然有这么多不同的训练流程,这很奇怪,而这正是 Harness 大放异彩的地方。
ARC-AGI 揭示的核心,是适应新问题、新分布的速度有多快。这些游戏背后投入了大量思考,确保游戏一到游戏二是正交技能,这样才能隔离出流体智力。Claude Opus 是最早在私有保留集上被验证的模型之一,只有 Greg 和 Chalet 能访问,最好成绩是 30%。而仅仅靠 Harness,这个被认为不值得研究的包装和脚手架,我们能到 95%,Nvidia 的 AVO 到了 100%,Prime Agent 和 Nvidia 都是最近刚出的。
还有一件事。Karpathy 三月推出 auto researcher,我 fork 之后本来只想做个小界面看进度,结果意外构建了一个 Harness。它的工作方式是:你指定一个目标。我给的例子是“扩散 LM 打不过自回归 LM”,但如果做集成,把扩散 LM 分片成多个实例,因为它的每 GPU 算术强度比 AR 高得多,分片后总体上可能更好。
我把目标给我的 Agent 群,给一些种子想法:改变集成大小,分片 100 次、10 次、5 次。再指定验证指标,比如 GSMAK 加 GPT2 的设置。然后 scoping Agent 去查论文和 GitHub 仓库,交给叫 Chris Ray 的 PI Agent,再交给叫 John South Khan 的研究 Agent,他去找 council,我和 Yaso 给反馈,Chris Ray 每小时催一次,最后进 author Agent,冻结想法、写消融实验、写论文。
它现在真的在发论文,我读过,写得不错。三、四月还很差,五月就好多了。现在我把八个想法交给八台 H100 节点,每台八张卡,就不管了,时不时检查一下收论文。真正变的是加在上面的Harness,我没花多少时间,但这基本就是我做研究的方式。
我花了个周末读了一批经典文献,做个五分钟的历史回顾。不按时间顺序,也会跳过很多论文。
最初的 Harness 就是 GPT-2,2019 年 2 月,一个 while 循环加 end-of-sequence 判断,加上 top-P 采样和环境,没了。没有工具调用,没有技能,这就是 V0版本。拿 GSMAK 举例:系统提示设定你是数学老师,上下文是“Susie 有五块钱,她花了三块,她现在有多少?”,没有 chain of thought,就是四个井号加两个 end-of-state 加 end-of-sequence,我们测四个井号之后的准确率。
之后六年一直在给静态 Harness 加功能。把一堆例子放回上下文,这就是 2020 年 7 月的 f-shot learners。然后 chain of thought,与其直接预测“井号井号 2”,不如把计算分散到更多 token 上。这些都是上下文、输出空间和动作空间的创新。然后是 WebGPT 和 tool former,给它工具,它可以调用。做减法时不用在权重里算 5 减 2,直接调 Python 的 sub 函数。这很酷,你可以在系统提示里暴露所有工具,工具就是这么来的。
然后 MemGPT,最酷的工具之一是能读写自己的上下文。在那之前只能不断追加,现在给它对上下文的增删改查权限,把一小块叫“记忆”。Voyager 再进一步:工具能串联完成任务,但学会了之后怎么提炼回系统提示让它永远记住?这就是“技能”,他们在 Minecraft 里做的,到现在还是技能的定义。intercode 是动作空间创新,直接输出代码就等于即时生成工具或技能。ReAct 先出来,然后 self-refine、reflection,思路是我有多个不同角色的 Agent,在上下文层面互相帮助自我改进。比如我把 3 和 5 弄反了,发给内部评估器问“这样对吗”,回答是“不对,看起来不对”,reflection 说“你把这两个弄反了,回去改一下”,这是最早的多 Agent 想法。
再往后,一个工具就能生成子 Agent,它们存在持久循环里,我可以调用,也可以不断加新的。RLM 更疯狂,递归调用 RLM query 解决更大类别的问题。这就是 Harness v1 版本,整个都是静态的,我没有改进系统提示,也没更新 Harness 本身。
得把 GStack 放在最上面,他让我们能做这一切,谢谢你 Gary。总结一下 V1:有 Agent 规范和系统提示,规定允许多少轮、多少次工具调用,列出工具、技能、子 Agent,放进循环里。它可以被 Slack 里的提示触发,今天会讲到的 QM 就是,我每天都在用;也可以跑在 cron 上,每小时醒来做点活。有会话管理、循环和上下文编译,把所有东西放进 LM 调用,拿回动作,再调工具、追加回上下文。
最令人兴奋的是让 Harness 自己学习,要么学系统提示,要么学 Harness 本身。DSPy 就是:Demonstrate、Search、Predict,拿一小部分示例学最优系统提示。我没法反向传播,但可以用遗传编程:找候选、合并、评估,这等于给了我系统提示本身的增删改查。Darwin Machines 更进一步,连 Harness 代码都能改:档案库里存着不同的 Harness 加系统提示组合,采样、跑适应度函数、加回档案。甚至有个元 Harness 允许 Agent 改自己的 Harness,越滚越好。元 Harness 在主 Harness 之上产生 Harness,非常元。
今晚现场有 Continual Harness 那篇论文的主要作者,一定要去找他聊。他们给记忆类别加了额外维度和历史记录。我觉得最酷的是给传统 RL 研究者的部分:Dagger 风格的在线学习,可以更新权重文件本身,基于刚学到的一小部分示例做测试时训练,这是个需要我们去实现的重要方向。
Prime Agent:把 Harness 当成Agent操作系统来设计
Seth Karten:今晚,我想说服大家用第一性原理思考怎么构建 Harness。
原始的 LLM 就是个顺序处理器,固定权重、可见上下文,token 进 token 出。但我们现在不这么看它了,我们有一组它能访问的文件,给它无穷的程序和工具,甚至能给其他 LLM 会话发消息、创建子 Agent,本质上它还是 token 进 token 出。Harness 就是 LLM 和世界之间的那一层,加上持久状态、工具和计算。
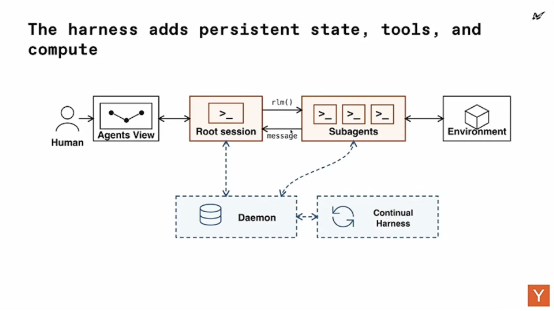
从人的角度看,你打开 Prime Agent 就像打开 Claude Code、Codex、Cursor,进入 Agent 视图,看到所有并行会话的概览,点进去是根会话,它是所有子 Agent 的项目编排器。你不用叫它启动子 Agent,有用的时候它自己会用,全部是编程式调用,因为一切都基于递归语言模型,所有工具、记忆、子 Agent 都在 IPython shell 里。每个 Agent 背后是持久守护进程,你合上笔记本或 Control-C 退出,它还在后台跑,必须显式停止。我们还从 continual Harness 借鉴了实时增删改查,管理记忆、技能、子 Agent,还能持久地改自己的系统提示。
我喜欢把我们构建的上下文看成 L1、L2、L3 的分层,像个缓存。最容易获取的信息是模型权重,但把所有信息都塞进权重意味着每次更新都要微调,太贵。所以有活跃的输入上下文,放上下文示例增强能力,但迟早会用完。最早的 Harness 形式就是压缩,让 Agent 总结自己的历史,超越上下文窗口。
一旦超越模型直接输入输出,进入 L2、L3。L3 更像调度状态,比如文件系统,从主内存读写。L2 介于活动上下文和文件系统之间,你有个实时 REPL,像 Jupyter 里的 IPython shell,变量都在 RAM 里,Agent 可以编程式操作,在上面跑程序,省大量 token。你还可以创建子Agent来节省上下文。
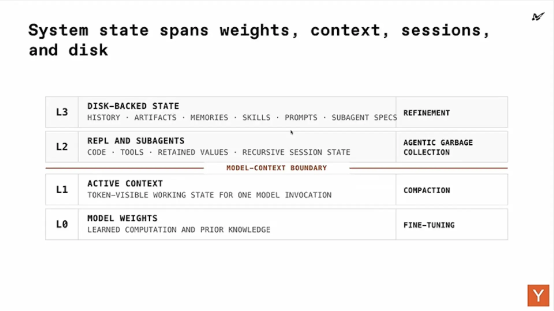
压缩让上下文随时间更新,但超过一定层面就要考虑怎么更新。我们讨论 CRUD,怎么超越简单的创建和读取,怎么随时更新和删除状态。我把 REPL 看作 Agentic 垃圾回收,清理变量,决定哪些子Agent可用,免得 RAM 让笔记本崩掉。再往上是refinement,更新和删除系统里的技能、记忆和提示词,免得硬盘被占满。
另一个我喜欢的视角:原始 LLM 更像图灵机,一条纸带,指令进去,操作完输出。Harness 更像冯·诺依曼计算机,可以在外部内存上读写,所以更强大,能处理更广泛的问题。
怎么构建好的 Harness?要尽可能有表达力。早期的 Harness 很具体,计划、行动、批评,执行固定步骤,但这些模型现在原生就会了,不需要显式强加 ReAct 循环。它不会的是压缩的表达能力、要有 Python REPL 跑程序、要能编程式创建子Agent、访问状态、有不同的反馈机制。这些表达性功能,你移除一个就是移除一项它没法用别的方式完成的能力。
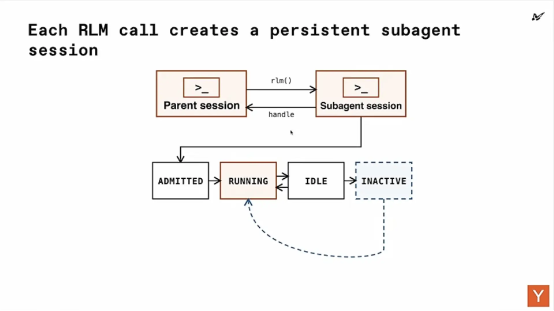
我合著者 Alex 的 RLM 论文你们可能熟悉。我们的扩展是把子Agent当成持久子会话:父会话创建并启动 RLM 子Agent,它们跑完任务报告最终状态后进入空闲,但仍然在 RAM 里。父会话随时可以发消息让它继续,它保有之前积累的上下文,不会丢信息。当然我们不想占太多 RAM,所以可以卸载到非活动状态,需要时再消息唤醒。
Continual Harness 是我之前一篇论文的内容,讨论对整个 Harness 状态编码。我们想把这种能力暴露给 Agent,让它用所有历史来更新未来的 Harness 长什么样:要改系统提示吗?要建技能吗?技能我理解成实现某个目标的一组指令或程序;记忆是重要事项的长期存储,还有持久存在的子Agent规格。有些子Agent上下文有用,以后还想复用。这种反思和refinement的能力对模型非常强大,它们现在还不擅长,但构建 Harness 时就应该让它比当前模型略强一点,这样你就能拿到推理轨迹,推动下一轮模型迭代,模型能处理 Harness,把自己引导到更高性能。
Prime Agent 里我最喜欢的功能之一,是从一开始就加的:任意两个Agent之间可以发消息。我一直在找管理我所有Agent的最好方式,它们每天在五个方向、五十亿个不同方向上为我做事,如果能直接互相分享联系方式并协调就好得多,事实证明这对软件工程和长周期任务也非常有用。
设计 Harness 时我们考虑长周期性能。我想跑些任务,不一直盯着,回来再检查进展。这是很多评估里缺失的视角:如果让一个模型跑的时间不够长,或者在一个预算后就停下,而另一个模型用更多预算继续工作,你既没有用相同支出比较,也隐藏了性能。我想看到实际的平台期,投入更多测试时 token 时,性能在哪个点只剩增量提升。
接下来会讲我们怎么做 Prime Agent,测试时扩展和结果,看看信息管理对 REPL 处理长上下文是不是真有用,以及在持续一周以上的超长周期任务里,refinement过程实际发生了什么。
这个 ARC-AGI 结果你们可能见过,我加了一个原始结果里没有的数据点,方便跨 Harness 比较。我们想找个大家关心的评估,就选了 ARC-AGI。我记得之前用 Continual Harness 加 Gemini Flash 拿到 20%,觉得至少能有 20%。结果是,我们的通用 Harness 根本没为 ARC-AGI 设计,却表现很好。
我上网找了个叫 Prolong 的社区排行榜,直接拿他们的系统提示词扔进 Prime Agent,第一次跑就 99.9%,然后我看日志发现我在作弊。于是老老实实做沙盒隔离,又花了一天。回来用 GPT-5.6 Sol 拿到 78%,我觉得这是个很棒的结果。
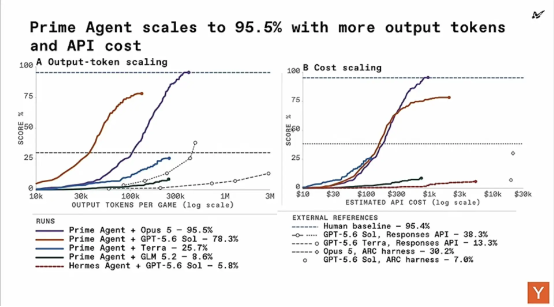
提示词很通用,就是用世界模型解 ARC-AGI-3,列出你能采取的行动,再加上 Prime Agent 的通用系统提示,你有 REPL,可以调用子Agent。我翻了轨迹,它在做各种编码调用检查场景、分析图像、做图像处理,看起来在利用 REPL 做合理推理。然后我们跑了 GPT-5.6 Terra,25.7%,相对前一周的结果很好,已经超过 GPT-5.6 Sol 的一些高配版本。跑 Opus 是 95.5%。
我们也和其他 Harness 比过。有人问我用 Claude Code 跑过吗,跑过,结果不好,所以我直接引用了 Claude Code 的原始结果,后来别人用类似 Prime Agent 的配置跑出了更好的成绩。有意思的是,很多很流行的 Harness 在 Prime Agent 表现好的地方不一定表现好。比如 Hermes Agent,很快就花掉很多钱,我花了五千美元没什么性能提升,只能中断。不是说这是他们的上限,但成本确实高。成本性能比很重要,能省钱的一个办法就是编程式地处理上下文。
长周期评估我们跑了 Oolong 和一些编码的 Emulator Bench,它很快发布,是 Program Bench 的替代品。结果主要是持平或略好,比如用 GLM-5.2 到 Opus 5 和 GPT-5.6 sol跟 Pimono、Claude Code 之类比。Emulator Bench 是复现整个计算机系统的模拟器,比如做一个 Game Boy Color。因为它有 REPL 和 RLM,能在提交最终方案前用这些程序做实验外的循环设计,更自由地试各种方案。GPU 内核也试了,不同模型上大致持平,一个更好一个更差,我们没有过拟合任何单一评估。
长周期这边我们还做了自动研究,用 NanoGPT Speedrun 扩展,给它 8 块 H200 跑一周。你可能觉得 Prime Agent 会好得多,因为它能编程。但任务方差高,很难归因到 Harness 还是模型。我们看到 DeepSeek-V4、GLM-5.3、Kim K3 这些较新的模型会做我们说的循环外实验:在 CPU 上跑实验、看参数化、做超参搜索、分析数据,这样就不用把所有时间花在昂贵的 H200 实验上。它跑的不是主实验,是为了优化主实验。这很酷,说明我们塑造表达性功能的方向是对的。它擅长自动研究,跟人配合就会更好,Human in the Loop能更好地引导实验。
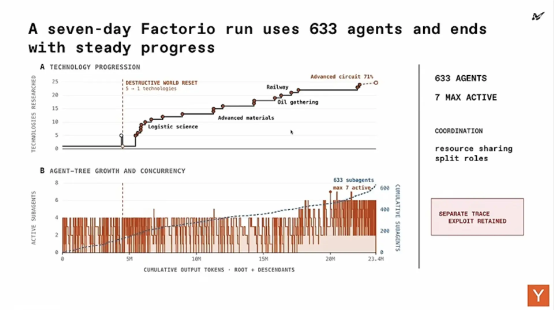
最后我们做了一次 7 天的工厂运行,633 个Agent,2300 万 Token 输出,目的是在科技树上持续取得进步。子Agent分工研究、建造、收集资源,还能用refinement机制借鉴过去经验,在超长上下文里不卡住。最有趣的是它一直没卡住,到阶段结束还在推进,有点像 Gemini 玩 Pokemon 那种结论。
如果只记一件事:去想想 Agentic 上下文管理,想想群体智能,深入研究 RLM,跑标准化评估。
OpenJarvis:把个人 AI 从云端拽回你的电脑
Jon Saad-Falcon:个人 AI 无处不在,但今天基本困在云端。很多 Harness 和项目做日常写作、研究、编码、日程,但像 OpenClaw 和 Hermes Agent 这类项目,大部分智能工作和查询都依赖云端 LLM。代价是成本很高,按年算 API 费用能到数千甚至数万美元;也不私密,最私人的数据发到云端,你不知道流向哪里;而且是在租智能,不是开箱即用就有;能耗还比在笔记本上跑高出几个数量级。
本地 LLM 终于够好了。今天的 LLM 只比之前的前沿模型落后 6 到 12 个月,比如 Qwen 3.8 27B 大致相当于 2025 年 8 月的 Claude 4.6 Opus。加上笔记本和工作站的加速器越来越好,这个差距在缩小。这周苹果刚发了新的 Mac Mini,苹果和 Nvidia 都在重新聚焦个人使用场景的加速器。
我们想探索的核心问题是:能不能把个人 AI 栈的核心,推理、Agent执行、记忆、学习这些主要依赖云端的部分,完全放在设备端跑,同时保持和纯云端栈的竞争力。所以我们做了 OpenJarvis,我们想知道在保证安全、隐私和质量的前提下,设备端免费能跑多少功能,为此我们定义了一组最简单的原语。
第一是用户界面。第二是围绕可组合推理、使用不同智能和工具的实际Agent逻辑。智能就是用来跑这一切的 LLM,可以是 Qwen、GPT-OSS、Gemma 3N。然后是推理引擎,Ollama、Llama.cpp、vLLM、SGLang,以及硬件,Apple Silicon 或 Nvidia。再加上通过标准 MCP 协议运行的工具和记忆。最后是学习原语,基于提示词的 JAPA、DSPy,或者基于权重的 GRPO、SFT、LoRA。你需要让Agent随时间改进,真正变得个性化、有效。
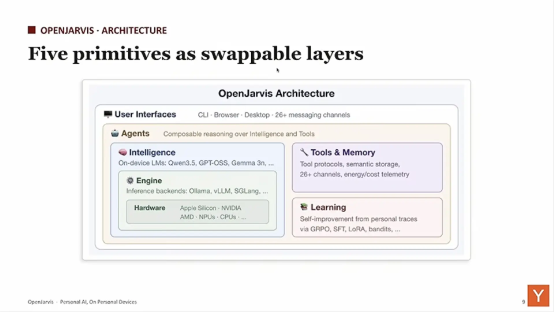
展示上,我们用人们已经习惯的界面:桌面端像平常一样运行,但能看到省了多少钱和能源;也能跑各种持续Agent,以 cron 任务形式日复一日运行标准协议。目标是和现有工作流即插即用,让人们第一次体验设备端 LLM,就像当年第一次用 ChatGPT 或 Claude。
为了优化,我们尽量不干扰 LLM,只写一份这五个原语的简单规格,让它们通过规格来优化。跑完整个优化循环,我们同时拿到了显著的成本下降、延迟下降和质量提升。这个配置覆盖了人们构建 LLM Harness 时最关心的五个方面:智能、引擎、Agentic逻辑、工具或学习系统,以及整体优化。
还有一件我觉得有意思的事:让云端 LLM 去手动和自动优化整个本地栈。这是利用云端模型的能力来诊断、提议、门控改动,为本地 LLM 生成改进方案,但真正部署做推理时不产生云端成本。我们发现经过 Claude 或 ChatGPT 优化的 Open Jarvis 配置,比开箱直接部署有效得多,因为你可以针对不同工作负载定制具体的 LLM 和 Harness。
结果是,即使在个人 AI、个人使用、编码和Agent这些不同工作流里,用今天的端侧模型我们也能和云端模型一较高下。还有很多任务本地模型做不了,但随着模型被更好地蒸馏、加速器更好,差距每个月都在惊人地缩小。即使用今天的模型,我们也做到了 800 倍的成本降低,同时显著减少延迟。而且不管选哪个云端模型做优化都有用,Opus 系列、Opus 5 和 GPT-5.6 Sol 自然最好,但 Gemini、Kimi、GLM 这些更大的模型家族也可以。
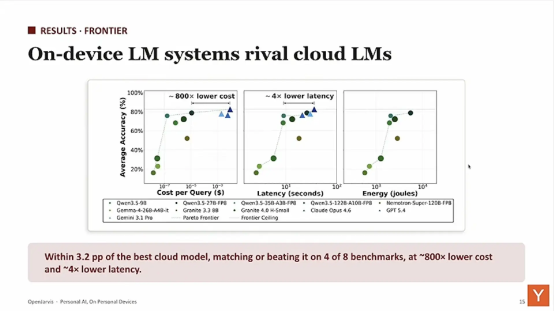
整个Harness的优化成本也比其他替代方案低,后者往往需要更多数据或更多模型调用。这套原语和规格对本地模型最有效,因为它让优化循环和模型抽象不再挡着云端模型,云端模型只需要专注优化整个系统。
展望未来,我们相信不久的将来,日常推理调用里很大一部分甚至大多数会转向本地设备和本地工作站。
QM:从 50 台 Mac Mini 舰队,到 YC 全员可用的开源系统
Josh France:我们做的是 QM,YC 的开源AgentHarness。QM 给 YC 每位员工一个类似 Claw 的助手,完全可定制,通过 Slack 或 Web 界面使用。每个人有自己的个人上下文、沙盒文件和定时任务,也能在多人在线环境里协作,比如 Slack 频道。用途很广:邮件分类、法律和财务工作流这类自动化,编辑文档、从内部数据库取数,还能启动实时的内部 Web 应用,比如帮忙规划活动。
为什么做这个?这是一系列内部Agent项目的结果,都吃到了模型能力变强的顺风。第一个是 2025 年 1 月左右的“通用Agen””,就是一个带工具的系统提示词在循环里跑,一刀切,所有人都在和同一个东西对话。架构简单,但回答数据问题出奇地好。有意思的是,随着底层模型改进,它擅长的范围也在扩大。后来我们把它接进 Slack,加了定时任务和更多工具。
2025 年 6 月,很多工程师开始用 Claud Code 和 Codex,我们发现在虚拟机里跑很容易,就接了一个 Slack 标签,对只想跑一次性代码改动的人来说很强。我们还让它跑 CI 管道、起开发环境测试。人们进来描述一个 bug,机器人去实际解决,对一辈子没改过代码的人来说这非常强大。我们还有个小循环,观察机器人怎么失败、在哪出错,然后更新代码库里的 Agents.md。
今年 1 月,很多合伙人开始用 OpenClaw。YC 合伙人极其忙碌,办公时间之间收到大量入站邮件,一直在读申请,所以任何能给他们额外杠杆的工具都很有价值。OpenClaw 特别有用,因为它是很多合伙人用的第一个拥有自己电脑的Agent,可定制性远超之前的范式,几乎像个人助理。所以四月的问题变成了:能不能不给每个人买一台 Mac Mini,也给每位员工提供这个?最后我们配了一个 50 多台虚拟机 Hermes Agent的集群。它们很有帮助,但需要大量配置,管理起来本质上很困难,有点像打地鼠,我得进去一个个修。于是就变成了:我们已经从这些系统里拿到很多价值,现在要构建一个东西,解决大集群的缺点,同时保住个性化和人们真正认可的部分。
Regan Bell:从 Josh 讲的能看出一个明显的趋势:模型在指数级改进,给它更多能力,回报也越来越可观。OpenClaw 给了Agent自己的电脑,回报很惊人。所以五月我们开始想,沿着这条线能推到多远?
我们很喜欢“解除束缚”这个视角,2024 年前后《情境意识》那会儿,测试时计算刚开始成为现实,我们第一次给Agent工具,有种直觉:模型里的智能比我们实际用到的多。如果大胆突破给Agent的能力边界,魔法就可能发生。
用 QM 做的第一件事,是把系统的大脑从沙盒里抽出来。用 Hermes 和 OpenClaw 时,Agent有自己的电脑,很强,但也被困在那台电脑里。哪怕只有几十个实例,管理几乎立刻变得难以驾驭,而且所有会话都困在本地。所以我们把所有东西卸载到 Postgres,全部集中化,包括和Agent的所有对话,再暴露给Agent本身,让它看到聚合起来的全部上下文。另一件事是不再把沙盒当成Agent居住的家,而是它能按需取用的资源,限制少得多。
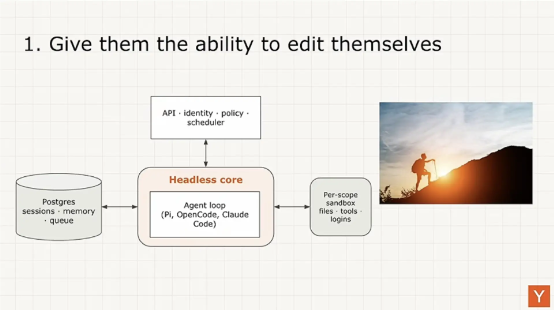
这样还带来一个可能:你会积累一个大型评估集,包含人们和Agent对话的所有轨迹,原则上可以做爬山式优化,形成自动改进循环。我们在这上面结果好坏参半。如果你放大量Agent去修它们遇到的所有 bug,用 LLM 当评判,会出现“主角综合症”,修复只看到大象的一部分,看不到整个系统。所以Human in the Loop一直很重要,虽然我们很期待它最终能完全自动。
另一件主要的事是把Agent接到公司里所有能接的资源上。YC 恰好已经有一个连了很多系统的 CLI,不在里面的就允许加任意 API 密钥。我们还希望它在员工笔记本上有同等能力,比如设备代码 OOTH 导入钥匙串再刷新,尽量模拟人在电脑上的体验。数据库主要保持只读,写入走人工审核的批量更新:Agent提出编辑计划,人快速过一遍,确认没有疯狂的东西再执行。我们观察到已经开始有点机械性地批准了,就像早期用 Claud Code 会仔细审查工具使用,慢慢就建立起信任。这是接下来几个月要盯的事。
沙盒我们当成Agent的资源,不是它的家。QM 里默认用分配给对话用户的那个沙盒,也有一些环境是Agent可以聚集协作的。如果要跑重型的开发负载,它可以去要一台资源更多的机器;处理简单的事就挑性能低一点的沙盒。把这个决定推给Agent而不是Harness,非常强。
类似地,允许Agent接入自己的运行时,如果能自己选提供商,就能摆脱一些情况,比如你们用 Fable 时肯定遇到过,想做 AI 研究、网络安全,什么都给你一堆拒绝,这时它可以跳到另一个模型。在不同沙盒提供商之间切换也常常有用。一般规则是Harness要极其精简,核心就三个工具:在远程沙盒中执行、从对象存储读写、发布内部应用,一个基于 Git 的简单系统。记忆和定时任务那些工具是临时性的,用来补系统中的粗糙边缘。
我们想成为面向 AGI 的预判性Harness。但还没到那一步,所以也遇到问题。一是Agent在一个很强的环境里、有所有工具,却经常过早放弃。过去一个月我们在实验“磨砺工具”:给目标设预算,没到一定的实际时间比如几个小时、或者一定的 Token 消耗,不允许放弃,这样能得到更好的研究输出和报告。看到 OpenAI 和 Anthropic 用非常类似的技术攻开放数学问题很有意思,普通办公室工作也一样适用。
另一个常见问题是,Harness要支持多人协作和 Slack,但因为训练产物的影响,Agent即使我们在系统提示里写得很清楚,还是会对自己的情境非常困惑,所以本地化的辅助手段很重要。
Josh France:还有一个问题是Agent不理解社交情境。具体说,如果我告诉 Regan 一条信息,他直觉上知道什么场合能分享,但要让Agent建立这个判断需要实际的工作,特权信息很容易泄漏到不该出现的上下文里。所以你能放进大脑的信息,实际上受限于权限系统有多好。YC 很幸运有多年积累的细粒度权限管理,但很多人没有,需要做工作才能在细微层面做知识共享。
演讲视频原链接:https://www.youtube.com/watch?v=n9xKblqyQ28