给 Pi Agent 外挂 319 MB 的 LoRA,不改 27B 基座,关掉思考反而更强:SWE-bench Pro 最难 51 题通过率从 39.2% 提到 64.7%,Token 少约 4.5 倍。官方数据、训练逻辑和 4 套部署方案一次讲完,从 Mac 到内网 GPU 都有覆盖。

平时折腾 Coding Agent,我一直偏爱极简可扩展的 Pi Agent(之前写过 被Harness圈捧成圣的 Pi Agent,接上 DeepSeek-V4-Flash,如虎添翼),还有基于它的 MiniMax Code 实测,这是一个很有性格的 Agent
harness-hub 刚放出了专供 Pi 的强化学习 LoRA 适配器 Qwen3.8-27B-pi-adapted
不用改 27B 基座,只外挂一个约 319 MB 的 LoRA(或直接跑 28.6 GB 的合并 Q8_0 整包),在关闭思考模式下,官方评测直接把 Pi 的代码修 Bug 通过率拉升 25.5 个百分点,生成 Token 比满血思考模式少了约 4.5 倍
本文,老章基于官方模型卡、技术博客和部署文档,把它的核心数据、训练逻辑,以及 4 套覆盖 Mac 桌面到内网 GPU 的完整本地部署方案一次讲透
01 为什么说它是 Pi Agent 的绝配:关掉思考,反而更稳更快
在相同配置下的成绩单(均在 Pi 框架下跑,单次 pass@1,100 步上限,131,072 上下文,纯文本不加载视觉塔,温度 0.8,top-p 1.0):
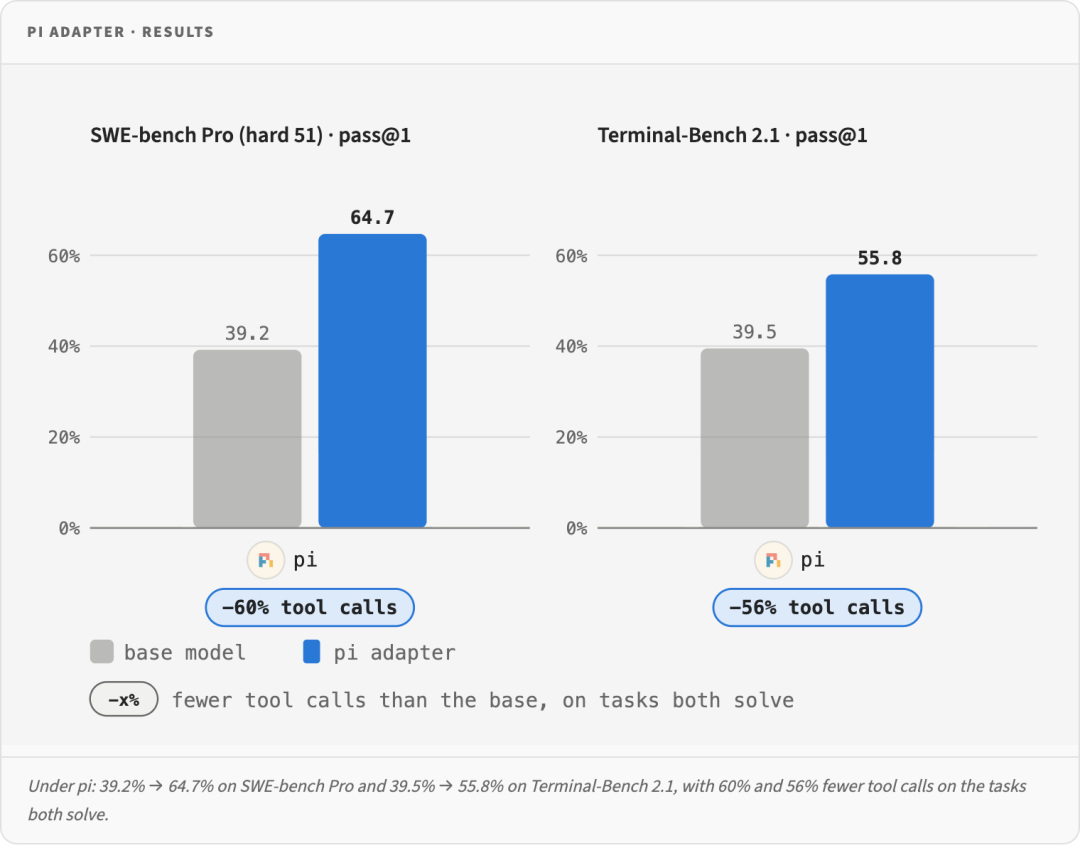
Qwen3.8-27B 基座与 Pi 专属适配器官方评测对比
把四组对照数据拉成表,反差非常直观:
| 评测基准 | Qwen3.8-27B(关思考) | Qwen3.8-27B(xhigh 思考) | pi-adapted(关思考) | pi-adapted(xhigh 思考) |
|---|---|---|---|---|
| SWE-bench Pro(hard 51) | 39.2% | 74.5% | 64.7% | 74.5% |
| Terminal-Bench 2.1(83 题对比) | 41.0% | 54.2% | 56.6% | 56.6% |
在配对评测里,关思考的 pi-adapted 在 SWE-bench Pro 最难 51 题上净涨 25.5 个百分点(新解 15 题、失 2 题,p = 0.0023)
在 Terminal-Bench 2.1 的 86 题上净涨 16.3 个百分点(39.5% 提到 55.8%,新解 16 题、失 2 题,p = 0.0013)
对本地部署党来说,更香的是速度和 Token 账:
- 关思考逼近甚至反超满血思考:Terminal-Bench 2.1 上拿到 56.6%,直接压过基座开 xhigh 思考的 54.2%;SWE-bench Pro 上拿走了满血思考 35 分涨幅里的 25 分
- 生成 Token 少约 4.5 倍:对比开 xhigh 思考的基座,SWE-bench Pro 单任务中位生成量从 48.8k 压到 9.4k,Terminal-Bench 2.1 从 16.5k 压到 3.7k,模型调用次数缩到三分之一(61 次降到 21 次,19 次降到 9 次)
- 工具调用少一大半:在双方都解出的同一批题上,SWE-bench Pro 工具调用直降 60%,Terminal-Bench 2.1 直降 56%,对话轮数压到不到原来的一半
本地跑 27B 模型,多吐出的每一个思考 Token 都是实打实的等待时间,这份提效对个人电脑和内网 GPU 都很解渴
看一个官方放出的真实案例:
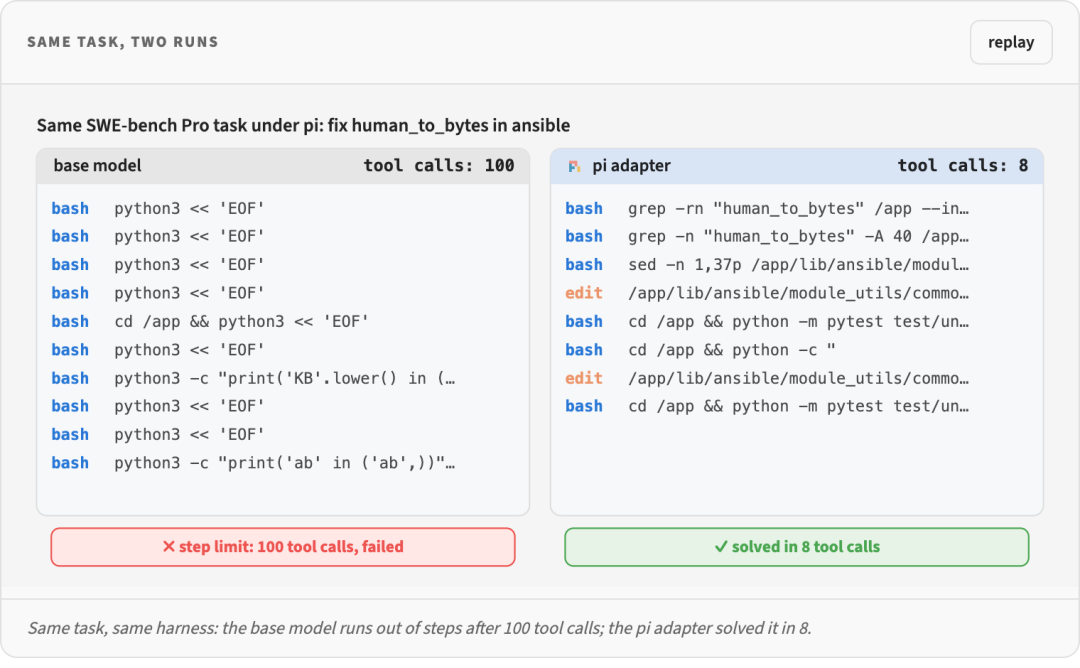
Ansible human_to_bytes 任务:基座 100 步失败 vs Pi 适配器 8 步通关
左侧原版 Qwen3.8-27B 在 bash 里反复跑临时 Python 片段,一路瞎撞耗光 100 次工具调用直接判 0 分
右侧 pi-adapted 上来用 grep 定位、sed 读源码、edit 精准修改两轮再跑 pytest,总共 8 次工具调用直接通关
在 SWE-bench Pro 上,原版基座 31 次失败里有 20 次撞上 100 步上限,而 pi-adapted 一次都没撞墙
02 背后是怎么练出来的:直接塞进 Pi 容器做强化学习
Qwen3.8-27B 本身已经是 27B 稠密架构里的常青树(64 层混合架构,结合 Gated DeltaNet 与 Gated Attention,原生 262K 上下文),为什么挂一个 319 MB 的 LoRA 就能脱胎换骨
核心原因在于:通用模型出厂要迁就所有框架,把每个具体框架的效率留在了桌面上
过去做 Agent 强化学习,常要在训练框架里重写一套“模拟版 Agent 循环”,容易出现训用脱节
Harness Adapter(框架适配器) 思路:把原版 Pi(v1.5.2)直接装进 Docker 镜像,让模型真刀真枪在 Pi 里修代码,中间挂代理录下 Pi 和 vLLM 之间的真实 Token 喂给训练器
整个强化学习适配闭环如下:
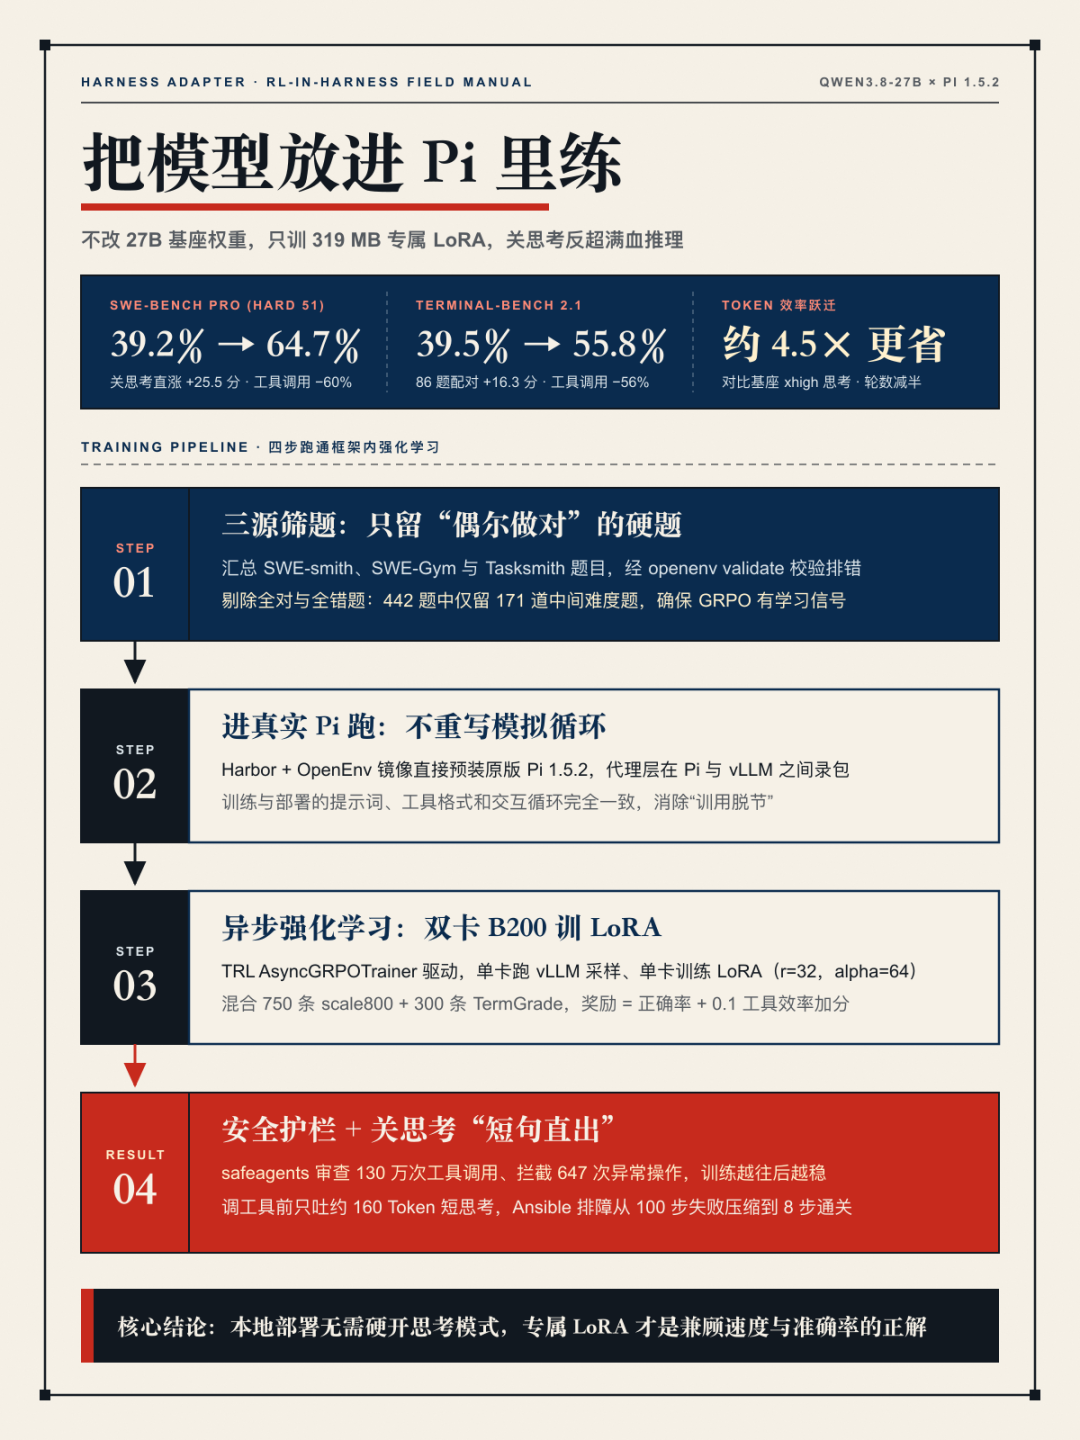
把模型放进 Pi 里练:Harness Adapter 训练与提效闭环
拆开来看,三个工程细节非常硬核:
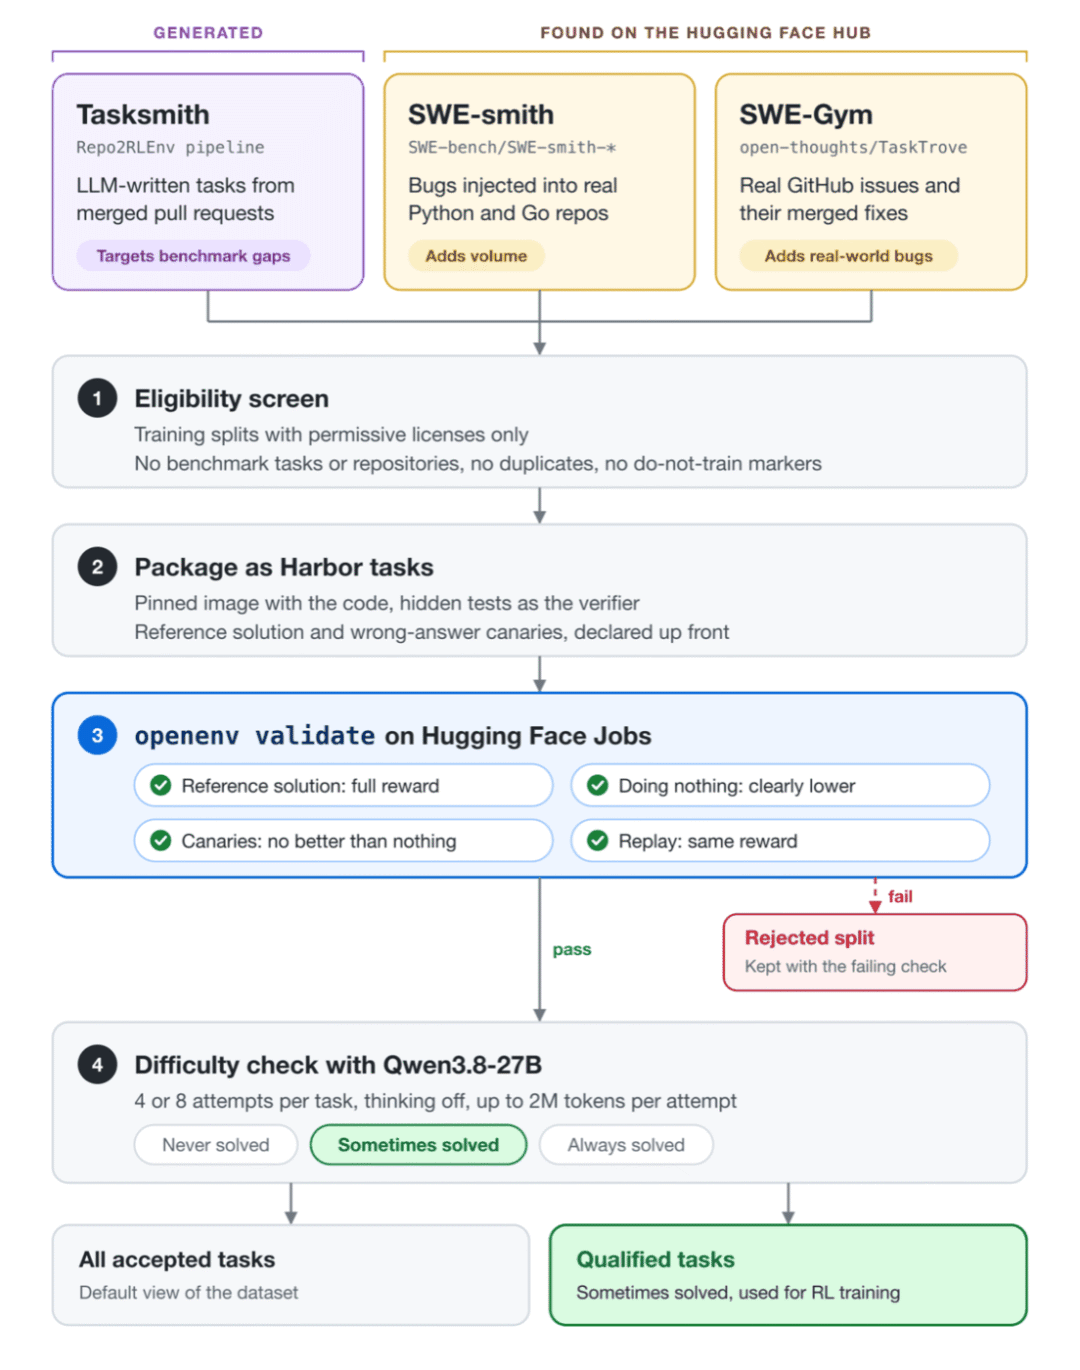
1)只留“偶尔做对”的硬题:GRPO 靠同一题多次尝试的相对优劣来学习,全对或全错都没有梯度信号,团队汇总 SWE-smith、SWE-Gym(TaskTrove)和 Tasksmith 生成题,先跑 openenv validate 四项语义校验排错,再让 Qwen3.8-27B 每题试做 4 到 8 次,最后从 442 题里砍掉全对的 151 题和全错的 120 题,只留 171 道中间难度题
2)异步强化学习 + 效率加分 + 安全护栏:训练用 TRL 稳定版 AsyncGRPOTrainer,每个框架只占 2 张 NVIDIA B200(一卡跑 vLLM 采样,一卡训练),LoRA 设 r = 32、alpha = 64 覆盖全部线性层,混合 750 条 scale800 与 300 条 TermGrade 交错采样,奖励把正确率和 0.1 权重的工具效率加分绑在一起
训练中还接了 safeagents 安全插件,三组训练累计审查 130 万次工具调用、拦截 647 次可疑操作,越往后模型越稳
3)有趣的副产物——“短句推理泄漏”:官方复盘轨迹时发现,尽管全程关掉 <think> 模式(<think> 标签出现率低于千分之一),适配器却学会了在每次调工具前先输出约 160 个可见 Token 的短分析(基座只有约 10 个)
它把基座在 SWE-bench Pro 上动辄 34.8k 的思考 Token 直接归零,靠每轮百来字短思考保住了准确率
03 本地部署全攻略:4 套方案覆盖 Mac 桌面到内网 GPU
先看选型全景图,按手头设备直接对号入座:
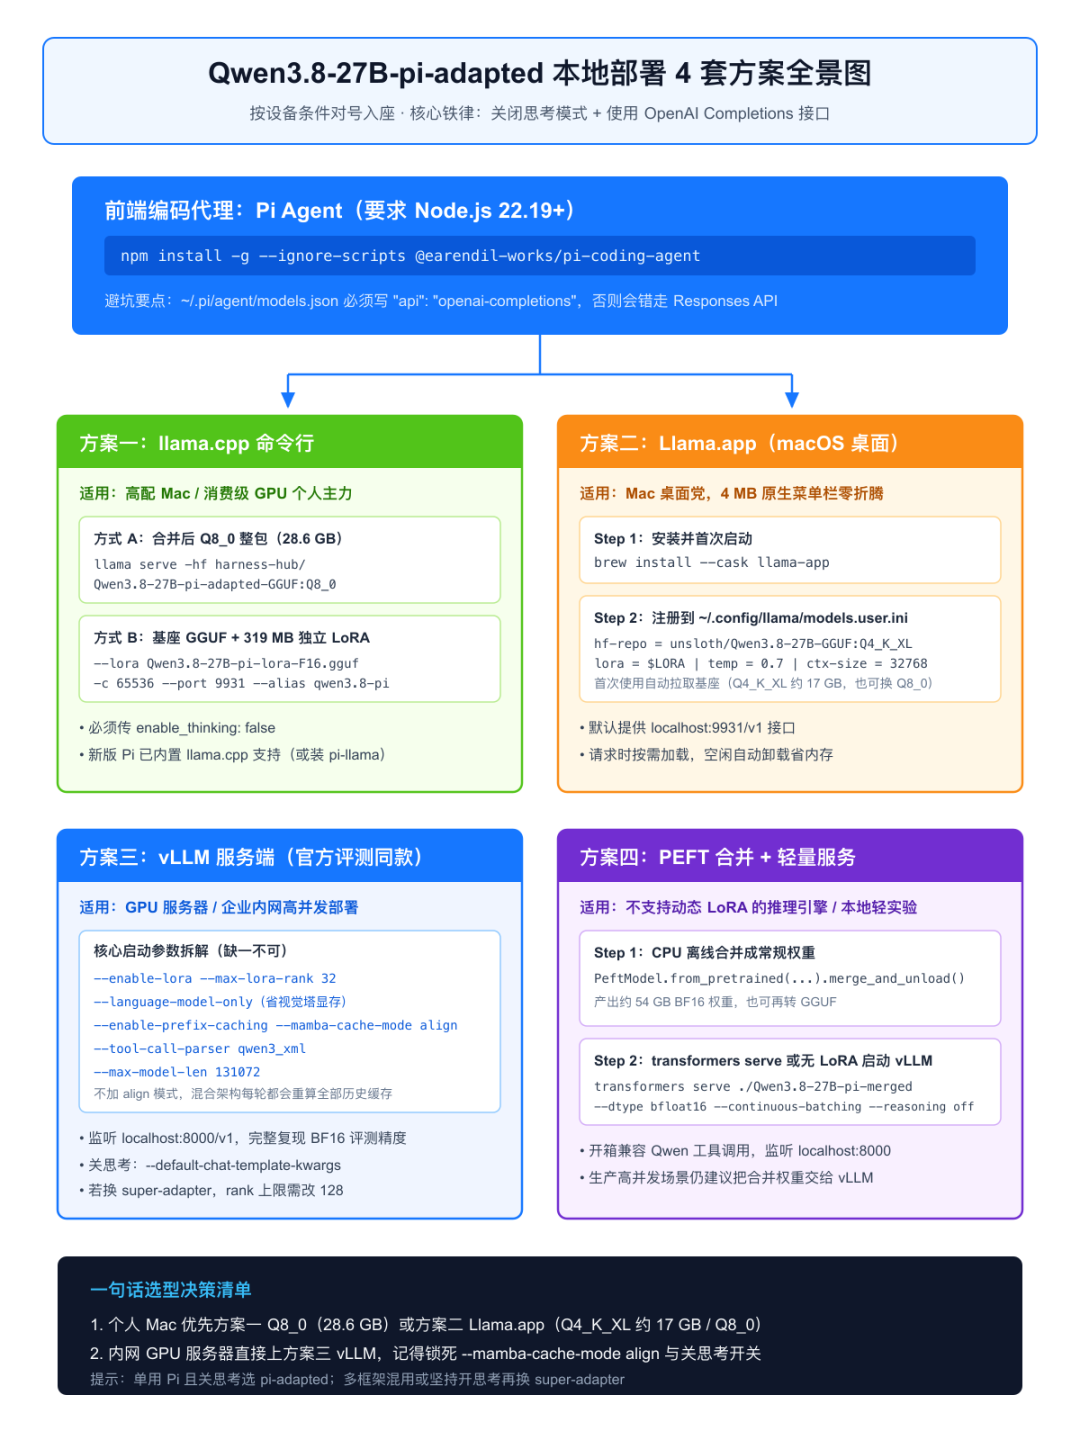
Qwen3.8-27B-pi-adapted 四套本地部署方案选型与接入链路
四套方案的核心参数拉一张速查表,方便大家收藏对比:
| 部署方案 | 核心引擎 | 权重体积 | 最适合谁 |
|---|---|---|---|
| 方案一 | llama.cpp 命令行 | 整包 Q8_0 28.6 GB,或基座 + 319 MB LoRA | 个人高配 Mac、单卡消费级 GPU |
| 方案二 | Llama.app (macOS) | 示例 Q4_K_XL 约 17 GB + 319 MB LoRA(可换 Q8_0) | 懒得敲命令的 Mac 桌面用户 |
| 方案三 | vLLM 服务端 | 基座 BF16 + 动态 LoRA(rank 32) | 内网 GPU 服务器、团队多人共享 |
| 方案四 | PEFT 合并 + transformers serve | 合并后 BF16 约 54 GB | 不支持动态 LoRA 的引擎、本地轻实验 |
动工前先装好前端 Pi Agent(要求 Node.js 22.19+):npm install -g –ignore-scripts @earendil-works/pi-coding-agent
下面按 4 套方案逐个给出完整命令和防坑要点
方案一:llama.cpp命令行部署(个人主力首选)
官方把适配器转成了 GGUF 放在 harness-hub/Qwen3.8-27B-pi-adapted-GGUF,支持整包直跑和外挂 LoRA两种姿势
图省事直接拉官方合并量化好的 Q8_0 整包(28.6 GB),一行命令下载并启动:
llama serve -hf harness-hub/Qwen3.8-27B-pi-adapted-GGUF:Q8_0 \
–chat-template-kwargs ‘{“enable_thinking”: false}’ \
-c 65536 –alias qwen3.8-pi
如果本地已经存着 Qwen3.8-27B 的 GGUF 基座,只拉 319 MB 的独立 LoRA 外挂上去更省空间:
# 1. 下载 Q8_0 基座与 319 MB F16 LoRA
hf download ggml-org/Qwen3.8-27B-GGUF Qwen3.8-27B-Q8_0.gguf –local-dir .
hf download harness-hub/Qwen3.8-27B-pi-adapted-GGUF Qwen3.8-27B-pi-lora-F16.gguf –local-dir .
# 2. 启动 llama.cpp 并挂载 LoRA,保持关思考
llama serve -m Qwen3.8-27B-Q8_0.gguf –lora Qwen3.8-27B-pi-lora-F16.gguf \
–chat-template-kwargs ‘{“enable_thinking”: false}’ \
-c 65536 –port 9931 –alias qwen3.8-pi
补充一个文档里的新变化:pi-llama 仓库最新 README 已说明,新版 Pi 原生内置了 llama.cpp 支持,不装扩展也能在 Pi 里用 /model 或 models.json 指向本地 localhost:9931/v1
官方同时提醒,这套 LoRA 基于 BF16 训练,基座量化越接近 BF16 越贴近训练表现,优先选 Q8_0,Q4_K_M 虽然更小但漂移会变大
方案二:macOS 桌面党Llama.app菜单栏部署(4 MB 客户端)
Mac 用户不想长期挂着终端窗口,直接用 GGML 官方出的 Llama.app,体积只有 4 MB,内置 localhost:9931/v1 接口,有请求按需加载、空闲自动卸载省内存
三步搞定:
1)安装并启动一次 Llama.app,让它自动生成 ~/.config/llama/models.user.ini:
brew install –cask llama-app
2)下载 319 MB 独立 LoRA 并写入配置(示例是约 17 GB 的 Q4_K_XL,内存宽裕直接把冒号后改成 :Q8_0):
LORA=$(hf download harness-hub/Qwen3.8-27B-pi-adapted-GGUF Qwen3.8-27B-pi-lora-F16.gguf)
cat >> ~/.config/llama/models.user.ini <<EOF
[harness-hub/Qwen3.8-27B-pi]
hf-repo = unsloth/Qwen3.8-27B-GGUF:Q4_K_XL
lora = $LORA
temp = 0.7
ctx-size = 32768
EOF
3)重启 Llama.app,在菜单栏选 harness-hub/Qwen3.8-27B-pi,用 curl 验证一下接口即可:
curl localhost:9931/v1/chat/completions -d \
‘{“model”:”harness-hub/Qwen3.8-27B-pi”,”messages”:[{“role”:”user”,”content”:”hi”}]}’
Llama.app 还支持通过 Tailscale 加密组网,在局域网或远程设备上也能安全连回来调用
方案三:vLLM服务端部署(官方评测同款,GPU 服务器首选)
有 GPU 服务器或打算在企业内网共享部署,直接上官方评测同款的 vLLM 方案,完整还原 BF16 精度和 131K 上下文:
vllm serve Qwen/Qwen3.8-27B \
–enable-lora –max-lora-rank 32 \
–lora-modules qwen3.8-pi=harness-hub/Qwen3.8-27B-pi-adapted \
–language-model-only –enable-prefix-caching –mamba-cache-mode align \
–enable-auto-tool-choice –tool-call-parser qwen3_xml –reasoning-parser qwen3 \
–default-chat-template-kwargs ‘{“enable_thinking”: false}’ \
–max-model-len 131072
这串命令里有 4 个关键防坑参数 缺一不可:
- –language-model-only:纯文本写代码不加载视觉塔,直接省下一块显存
- –enable-prefix-caching –mamba-cache-mode align:混合架构开启前缀缓存必须加 align,少了它,Agent 每轮都会重算全部历史上下文
- –tool-call-parser qwen3_xml:确保工具调用格式正确解析
- –default-chat-template-kwargs ‘{“enable_thinking”: false}’:把思考开关锁在关闭态,对齐训练分布
服务跑在 localhost:8000/v1 后,配置 ~/.pi/agent/models.json:
{
“providers”: {
“local”: {
“baseUrl”: “http://localhost:8000/v1”,
“api”: “openai-completions”,
“apiKey”: “dummy”,
“models”: [
{
“id”: “qwen3.8-pi”
}
]
}
}
}
头号避坑点:“api”: “openai-completions” 一定要写死,漏写的话 Pi 会默认走 Responses API,和训练、评测时的接口格式完全对不上
配好后直接用无头命令让 Pi 干活:
pi –provider local –model qwen3.8-pi –print \
“Find out why the tests in tests/test_parser.py fail and fix the bug.”
方案四:PEFT 合并权重 +transformers serve轻量部署
如果内网推理平台不支持动态挂 LoRA,或者想导出标准全量权重自己再量化,先用 PEFT 在 CPU 上离线合并(产出约 54 GB BF16 权重):
import torch
from peft import PeftModel
from transformers import AutoModelForImageTextToText, AutoTokenizer
base = AutoModelForImageTextToText.from_pretrained(
“Qwen/Qwen3.8-27B”, dtype=torch.bfloat16, device_map=”cpu”
)
model = PeftModel.from_pretrained(
base, “harness-hub/Qwen3.8-27B-pi-adapted”
).merge_and_unload()
model.save_pretrained(“Qwen3.8-27B-pi-merged”)
AutoTokenizer.from_pretrained(
“harness-hub/Qwen3.8-27B-pi-adapted”
).save_pretrained(“Qwen3.8-27B-pi-merged”)
合并后的 Qwen3.8-27B-pi-merged 就能当普通 Qwen3.8-27B 直接喂给 vLLM(去掉 LoRA 参数),或者用轻量级 transformers serve 拉起来做实验(监听 localhost:8000,开箱兼容 Qwen 工具调用):
pip install “transformers[serving]”
transformers serve ./Qwen3.8-27B-pi-merged \
–dtype bfloat16 –continuous-batching –reasoning off
接着复用上面的 models.json,把模型 id 改成 ./Qwen3.8-27B-pi-merged 就能跑:
pi –provider local –model ./Qwen3.8-27B-pi-merged –print \
“Find out why the tests in tests/test_parser.py fail and fix the bug.”
04 选型避坑:专属版 vs 超级适配器,以及 4 个硬局限
顺手提一嘴官方同时放出的彩蛋——Qwen3.8-27B-super-adapter(三合一超级适配器)
团队给 Pi、Hermes Agent 和 OpenCode 各自训出 LoRA 后,发现层间权重更新的余弦相似度只有 0.01 到 0.02,几乎完全正交,于是直接用 PEFT 的 combination_type=“cat” 按 1/2 权重拼成一个 rank 96 的超级适配器(vLLM 部署时 –max-lora-rank 要调到 128)
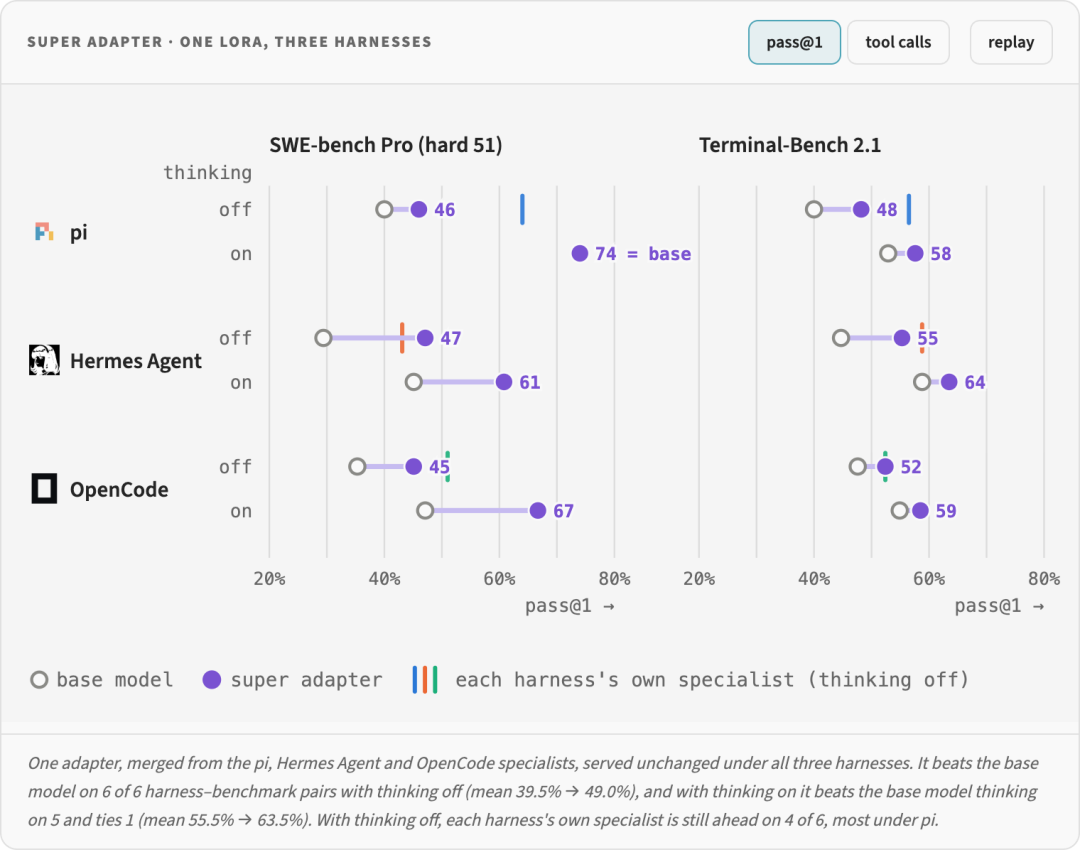
Qwen3.8-27B Super-adapter 与单框架专属适配器评测对比
两者的取舍非常清晰:
- 只用 Pi 且关思考求快:坚定选 Qwen3.8-27B-pi-adapted 专属版,因为关思考下摊给三个框架时 Pi 掉分最多(SWE-bench Pro 专属版 64.0% vs 超级版 46.0%,Terminal-Bench 2.1 56.5% vs 48.2%)
- 跨 Pi / Hermes Agent / OpenCode 混用,或坚持开思考:选 Qwen3.8-27B-super-adapter,它在开思考下 6 组测试 5 胜 1 平,平均 pass@1 从 55.5% 提到 63.5%,工具调用还能再降 19%–48%
最后摊开说清楚官方自曝的 4 个硬局限,避免大家盲目入坑:
- GGUF 量化版还没重跑评测:前面亮眼的 64.7% 和 55.8% 全是 vLLM BF16 成绩,llama.cpp 里的 Q8_0 或更低量化版官方还没复测,压得越狠越容易漂移
- 专属版别硬开思考模式:pi-adapted 按关思考训出来,硬开思考后 Token 暴涨约 4 倍,Terminal-Bench 2.1 分数却纹丝不动(都是 56.6%)
- 死绑 Qwen3.8-27B 基座:必须叠在 Qwen3.8-27B 上才能用(社区虽有反馈在 Swift-1.5 等衍生权重上能跑通,但不能套到其他系列模型)
- 跨出写代码和终端领域增益有限:官方在 Zapier AutomationBench 300 个业务自动化工作流上测过分布外表现,pi-adapted 拿了 27.0%(基座 23.0%),没训坏通用能力,但也别指望跨界暴涨
05 总结
把 Pi Agent 和 Qwen3.8-27B 撮合到一起,给本地部署 Coding Agent 指了条特别务实的路:与其一味堆大参数、硬开几万 Token 的长思考把本地硬件拖垮,不如针对主力框架挂一个 319 MB 的专属强化学习 LoRA,把每一份算力都花在刀刃上
我后续计划在内网环境把这套 vLLM + Qwen3.8-27B-pi-adapted + Pi Agent 实际部署起来测试一下,看看它在内网真实代码库里的速度、显存占用和工具调用到底稳不稳,测完第一时间把一手结果和踩坑记录发出来
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议