最近看国产大模型的新闻,我有一种错觉:怎么大家都是第一?咋滴啦,难不成大模型圈误入了手机、汽车行业圈套了?
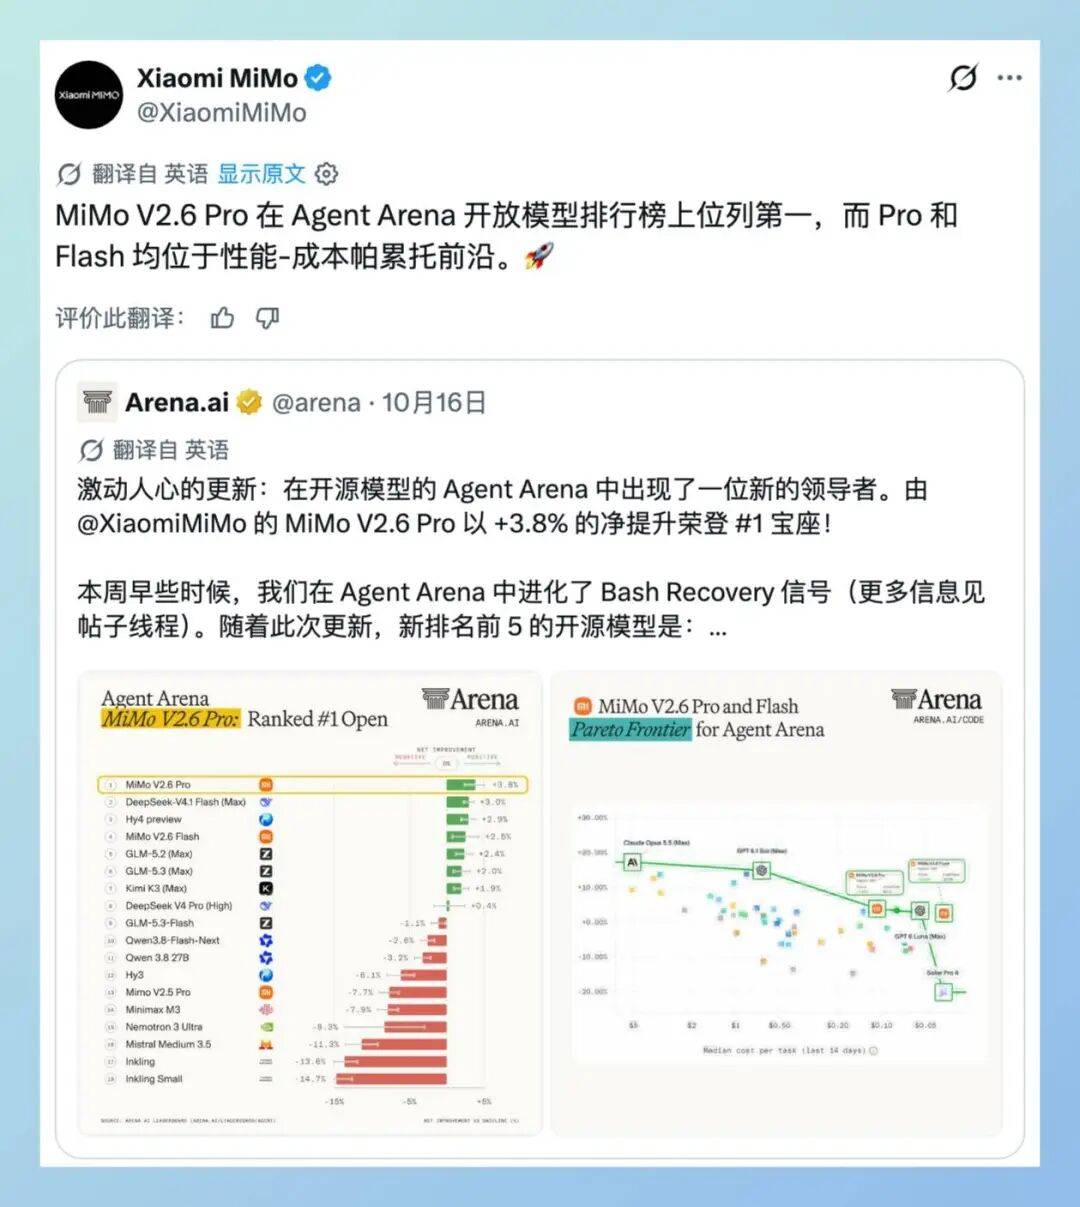
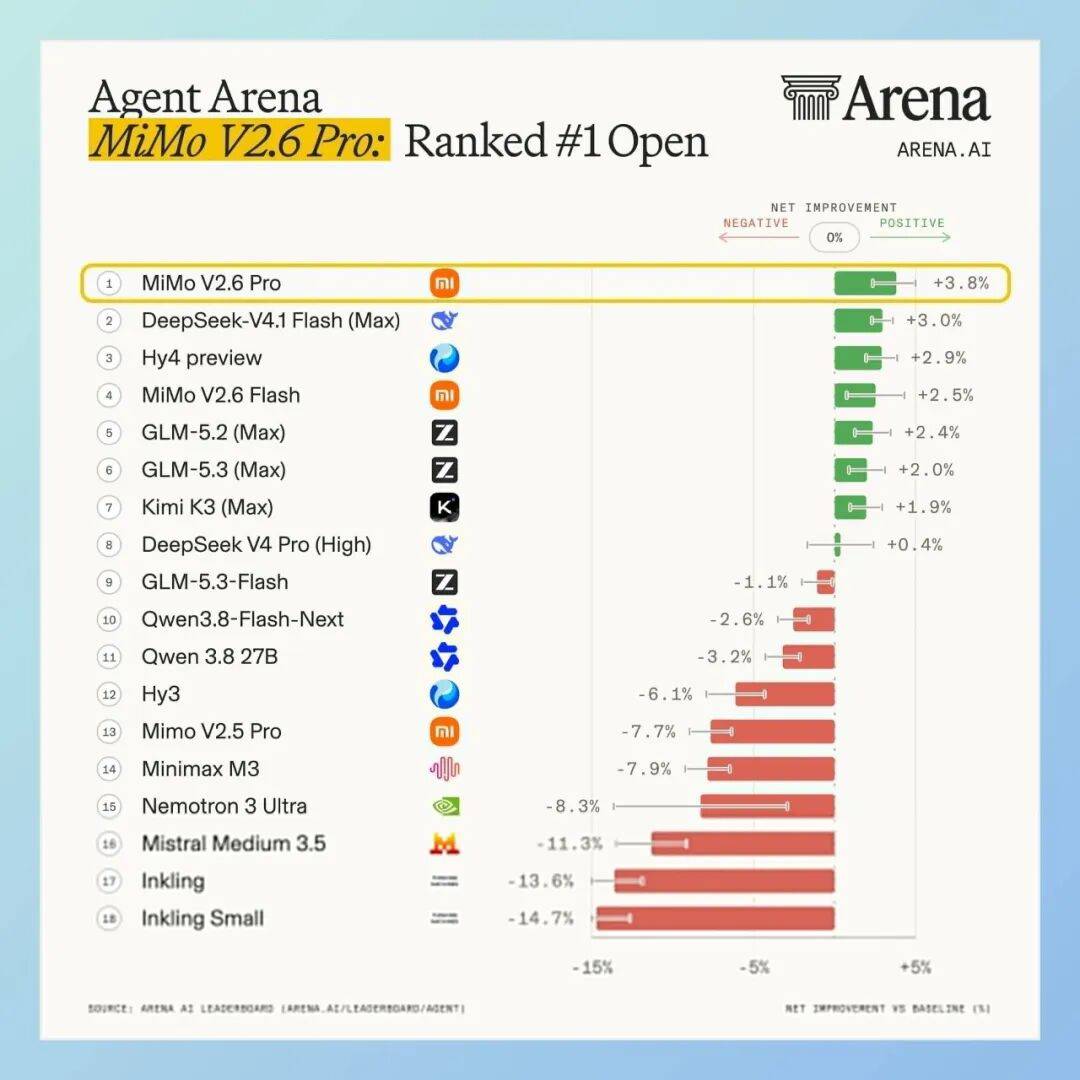
9月,小米发布MiMo-V2.6,拿下全球开源大模型第一、国产模型第一。
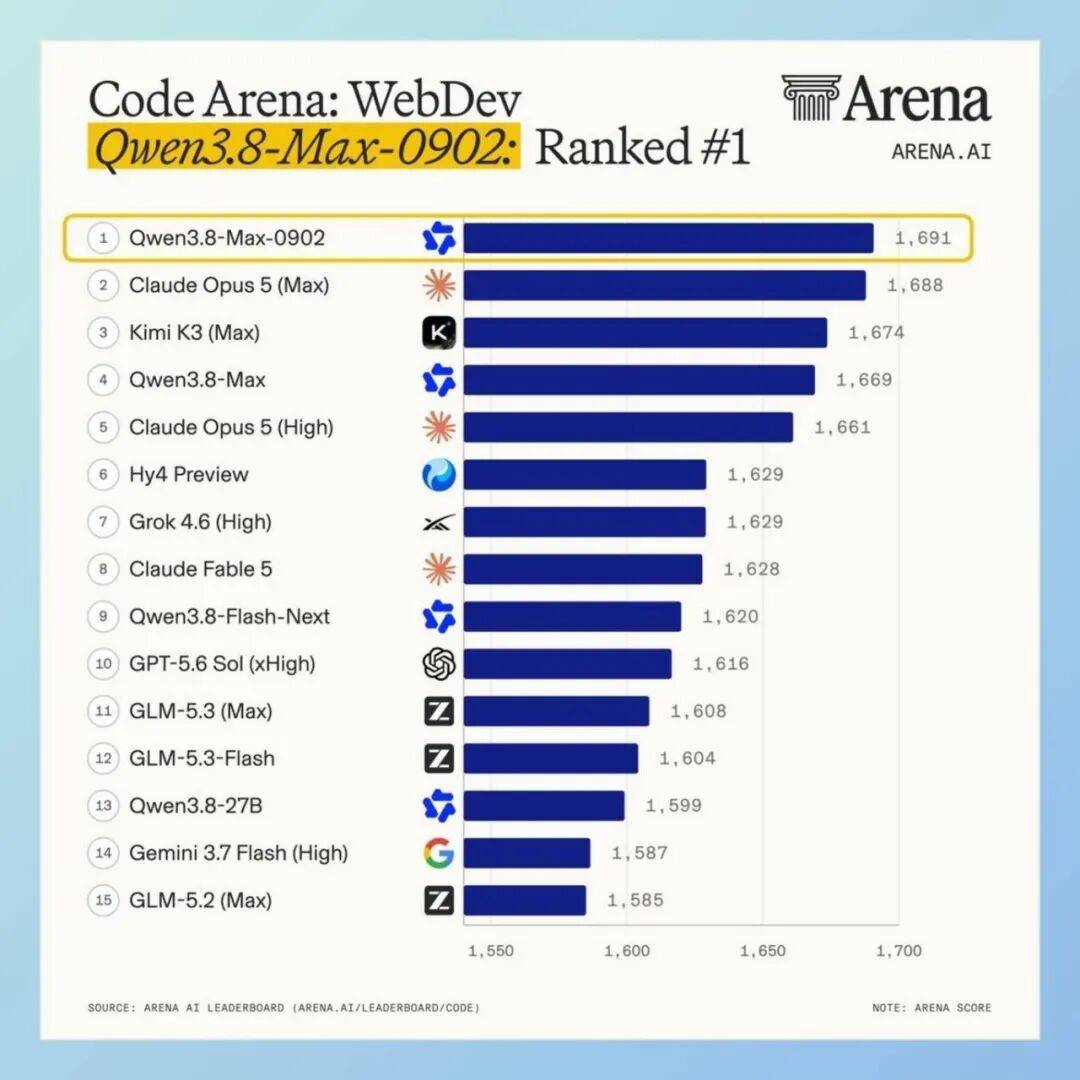
差不多同一时间,阿里千问Qwen3.8-Max升级,拿下前端编程全球第一。
Kimi、智谱、DeepSeek也都有各自拿得出手的榜单成绩。
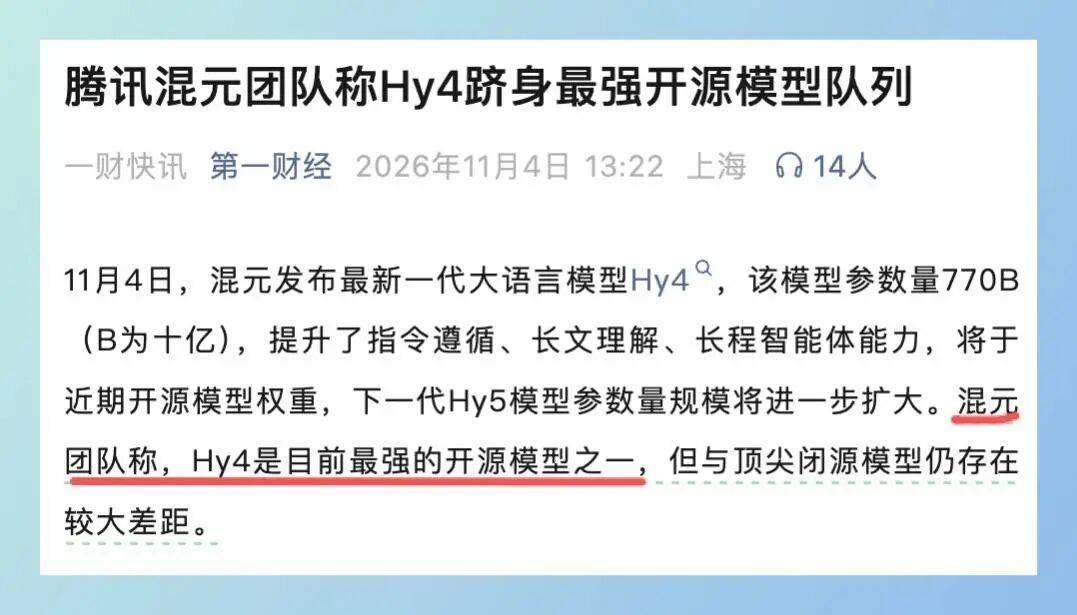
11月4日,腾讯混元Hy4正式发布,宣传口径是跻身全球最强开源模型之列。
如果给国产大模型办一场颁奖典礼,主持人可能要提前多准备几箱奖杯。
腾讯这次的措辞倒还算克制,特意留了个“之一”。
毕竟国内大模型竞争这么激烈,第一名都快不够分了。
01、怎么大家都能拿第一?
我专门查了一下,还真不能说这些成绩是乱吹的。
小米MiMo-V2.6-Pro在9月22日发布时,凭借46分登顶Artificial Analysis综合智能指数开源模型榜,超过了当时的Kimi K3和千问Qwen3.8 Max。
阿里千问的第一来自另一个赛场。
9月2日,Qwen3.8-Max-0902在CodeArena前端编程榜拿到1691分,登上榜首。
一个考综合智能,一个考前端开发,考试科目都不同,当然可以同时拿第一。
而且榜单随时会变。
9月2日还在前端编程榜第一的千问,到了9月7日的新一周榜单,就已经排到了第四。
腾讯混元也经历着类似的排名变化。
此前Hy4 preview在Agent Arena开放模型中排第二、全球总榜第十。到了11月1日,开放模型榜单已经变成小米MiMo-V2.6-Pro第一,混元Hy4 preview第四。
大模型厂商在发布会上晒出来的成绩单,通常都会选择自己最擅长的科目,以及表现最好的那个时间点。
这套玩法看着是不是有些熟悉?
以前手机厂商拼跑分、拍照、续航,每家都有冠军项目。现在轮到大模型厂商拼推理、编程、Agent、数学和性价比。
只要细分赛道足够多,总能找到值得庆祝的成绩。
不过话说回来,国产模型能在这么多领域和全球顶尖模型竞争,确实是好事。至少这些第一名,已经不全是在国内几个选手之间比出来的。
02、腾讯混元,这次到底有多强?
调侃归调侃,Hy4这次升级还是有不少看点的。
首先是模型规模。
Hy4系列总参数达到7700亿,而上一代Hy3还不到3000亿。
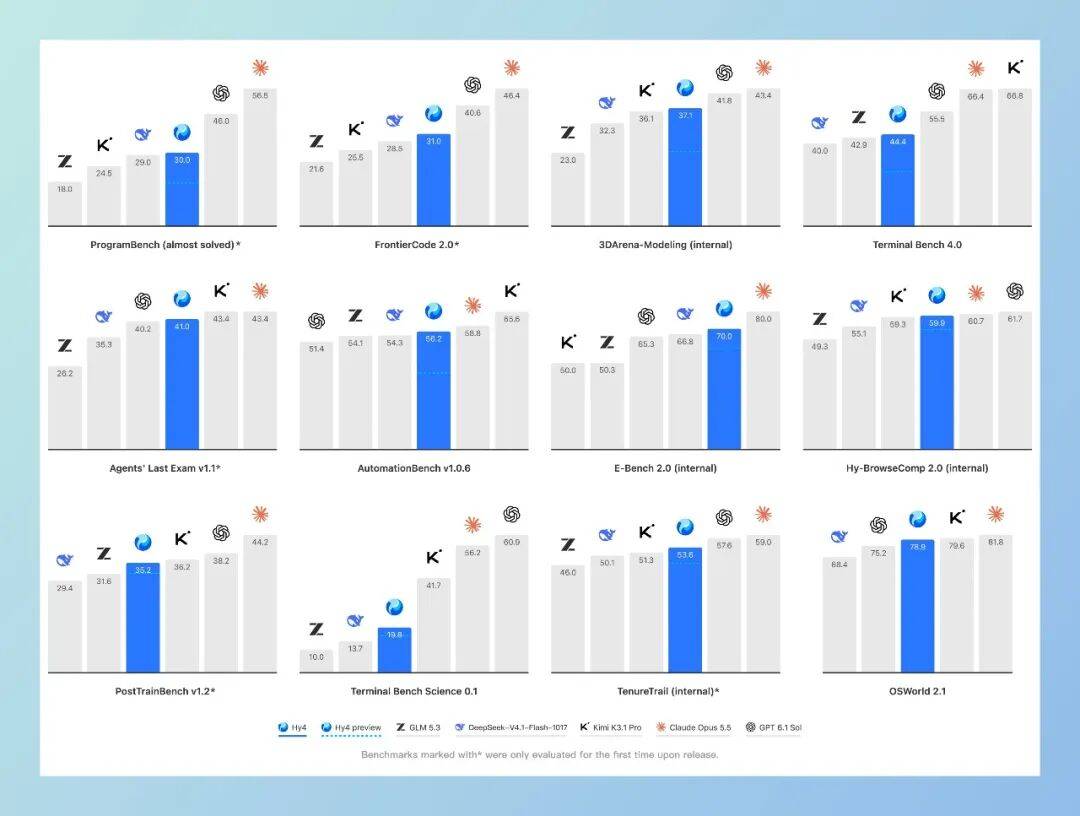
相较于此前发布的Hy4 preview,正式版进一步扩大了训练规模,还首次加入视觉理解能力,强化了指令遵循、长文理解和长程智能体能力。
比如现在很多人用AI写代码、制作PPT、分析数据,甚至让AI操作电脑里的专业软件。
这些任务对模型的要求越来越高。生成一份漂亮的PPT不算太难,但让AI自己查资料、整理逻辑、操作软件、调整排版,最后交付一份能直接使用的文件,就没那么简单了。
Hy4重点强化的就是这类长时间、多步骤的工作任务。
另外,腾讯还在尝试让AI参与AI研发。
这次发布材料提到,Hy4结合Hyra2.0,已经可以参与优化部分模型训练基础设施,并协助研发面向科学研究的专用模型。
这条路线和小米MiMo最近强调的递归自我改进(RSI)有些相似,都在探索利用模型能力提升下一代模型的研发效率。
不过,这些探索还远远谈不上AI已经能够独立完成自己的研发。
至于Hy4能不能真正登顶,正式版还需要接受更多第三方评测。腾讯自己也承认,混元与顶尖闭源模型仍有明显差距。
03 、马化腾手里的AI产品,终于能一起升级了
在我看来,比混元拿到第几名更值得关注的,是腾讯已经攒下了一大批AI产品。
元宝、ima、WorkBuddy、CodeBuddy,还有最近陆续推出的各种Buddy。
此前盘点腾讯AI产品的时候,我还调侃过,产品多到马化腾自己都不一定认得全。
现在,这个庞大的AI产品家族又多了一次集体升级的机会。
Hy4已经接入WorkBuddy、CodeBuddy、元宝、ima等产品,后续还将服务QQ、游戏、微信读书等更多业务场景。
对于腾讯来说,这是一笔相当有价值的资产。
比如WorkBuddy每天都在面对真实的办公任务,CodeBuddy可以积累开发者在写代码、调试和修改项目时遇到的问题,ima则有大量文档和知识管理场景。
腾讯可以让模型和产品相互磨合,利用真实场景发现问题、改进体验。
而且模型能力提升以后,未必需要用户专门打开一个新的AI应用。原来使用的办公软件、开发工具、内容产品,都有机会获得更强的AI能力。
当然,腾讯也有自己的难题。
这么多产品,能不能真正打通?用户在一个产品里交给AI的任务,能不能顺畅地延续到另一个产品?不同业务之间的数据权限又怎么处理?
这些事情的复杂程度,可能一点都不比训练一个大模型低。
腾讯已经有了很不错的模型底座,接下来就看各个产品团队怎么使用了。
04、第一名越来越多,用户到底该信谁?
现在国产大模型迭代速度实在太快了。
小米、阿里、腾讯、字节、百度、DeepSeek、Kimi、智谱,谁都不愿意落后。
今天你刷新编程榜,明天我刷新推理榜,过两天又有人发布新模型,把大家的排名重新洗一遍。
对厂商来说,排行榜是最直观的技术宣传材料。尤其是在企业采购、开发者选型和融资市场,排名靠前确实有价值。
但对于普通用户来说,真正关心的问题可能简单得多。
让AI做一份PPT,哪个模型做得好?让AI写一个网站,哪个模型修改次数少?让AI处理一份复杂Excel,哪个模型不会中途出错?
还有一项非常现实的指标:价格。
一个模型能力再强,如果执行任务时消耗的Token贵得吓人,普通用户和中小企业可能也用不起。
所以,现在看大模型榜单,我通常会多看几眼排名后面的评测任务、测试日期和实际使用成本。
发布会上的第一名有很多,用户每天打开的AI应用就那么几个。
腾讯混元Hy4这次算是姚顺雨交出了一份有竞争力的成绩单。接下来,WorkBuddy、CodeBuddy、元宝能不能因此变得更好用,才是用户所期待的,也是真正想看到的。
至于国产大模型到底谁是第一,跟用户没啥关系,毕竟谁都可以说第一,只要换个维度就行了。
本文由作者@怪哥,授权发布于平台,未经许可禁止转载。