本文来自微信公众号: AGI 2050 ,作者:AGI 2050,原文标题:《Anthropic 工程师:别再用老办法写提示词了,它正在拖累你的 Claude》
在近期AI Engineer纽约大会的一场演讲中,Anthropic技术专家兰斯·马丁分享了几个简单却极其有效的实用技巧,帮助开发者充分释放前沿大模型的潜力,往往能在提升输出质量的同时大幅削减成本。
本期内容2026年11月6日播出,原视频时长64分钟。
以下为精选演讲内容,全文约8800字,阅读时长约8分钟。
开场:你可能还没站上成本—效果前沿
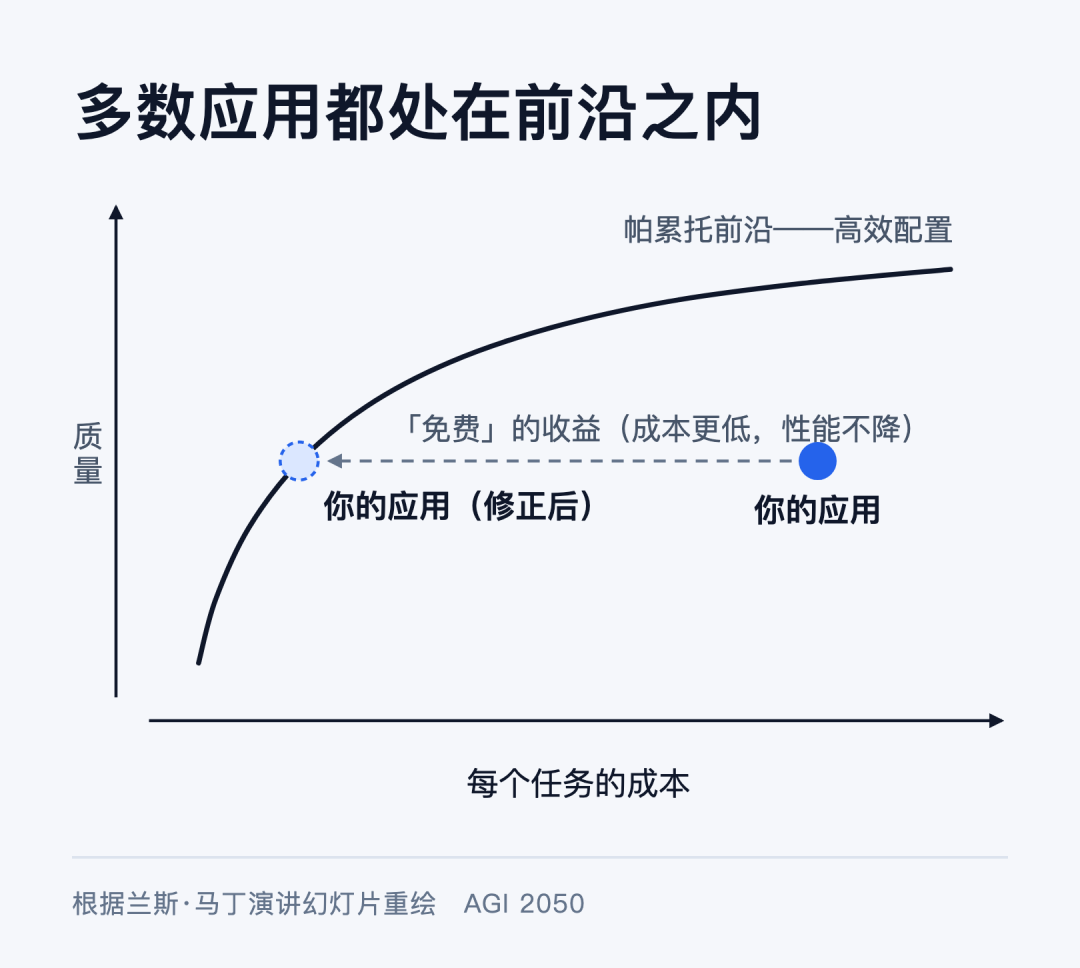
我们通常认为,成本和质量是一对矛盾。想要更好的性能,就得砸更多钱;想要省钱,就得牺牲性能。在任何一个评测集上,不同模型都会画出一条“帕累托前沿”(指在成本与性能之间达到最优平衡的边界曲线)。在这条曲线上,Fable位于最右端,往下依次是Opus、Sonnet,然后是Haiku。
兰斯·马丁在AI Engineer纽约大会的工作坊上(2026年10月12日,视频画面)
但今天我想挑明一个事实:很多时候,你的应用根本没摸到这条前沿曲线。因为一些微小的配置失误,你的应用其实落在曲线内侧。我们已经反复看到,很多客户仅仅做了一点简单的调整,就同时实现了性能提升和成本下降。接下来我将围绕五个核心主题,演示如何修复这些问题。
一、给提示词做个全面体检
第一件事:审查你的提示词。
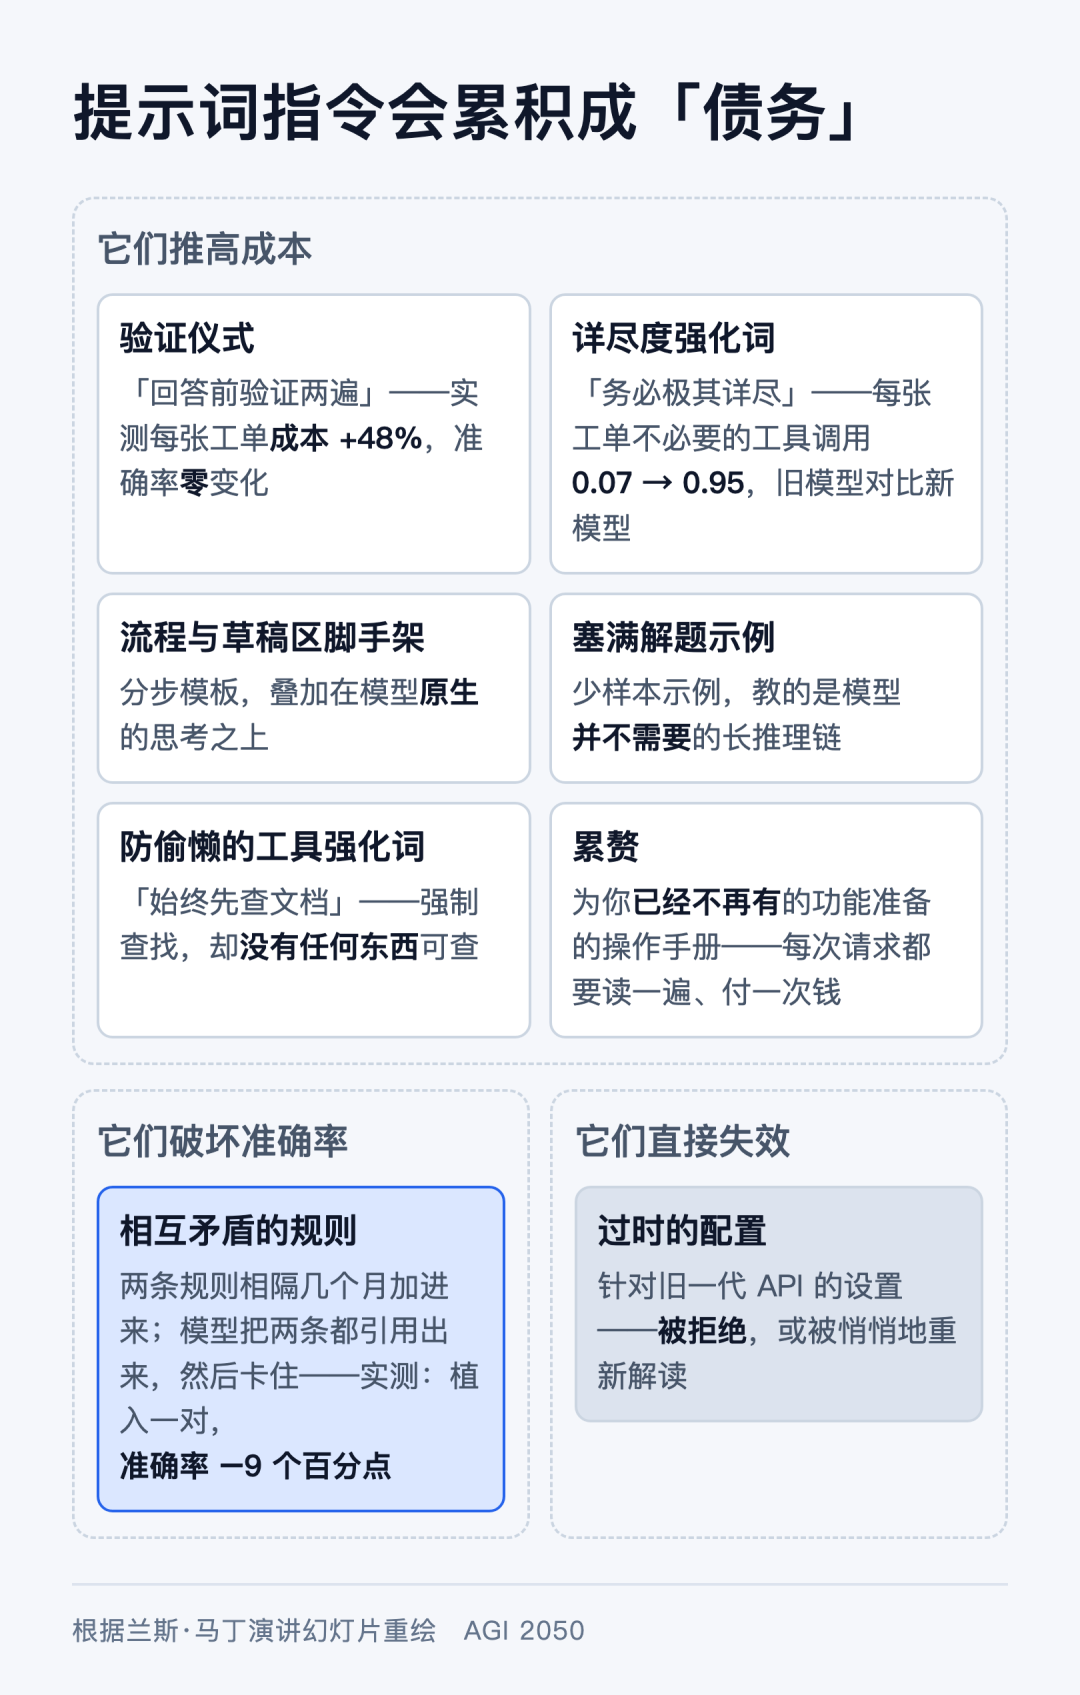
提示词就像代码一样,时间长了也会攒下“技术债”。回想几代模型之前,大家习惯在提示词里写“请一步步思考”;习惯加上各种验证仪式,比如“仔细检查你的工作”;还会塞进各种督促思考的强化词,比如“务必做到极致详尽”;有时候甚至会专门开辟“草稿区”,手把手教智能体怎么思考、把思考过程写在哪里。
现在完全不需要这套了。前沿大模型本身就很擅长思考,也知道什么时候该思考。它们不需要你教怎么干活、怎么检查作业,自检已经成为它们的本能。更糟糕的是,继续保留这些旧习惯不仅会推高成本,有时还会拉低性能。
还有一个有意思的现象:以前的模型如果遇到提示词里存在自相矛盾的规则,由于指令遵循能力没那么强,往往会自动忽略其中一条,最后勉强也能跑通。但现在的前沿模型遇到矛盾的规则,反而常常会被搞糊涂。
现在就可以动手做一件极简单的事。如果你手头有想检查的代码,可以在Claude Code里直接运行/checkup prompt-audit命令,或者运行/claude-api prompt-audit。这是Claude Code里的两个技能,底层指向同一套代码,只是调用入口不同:/checkup通常用来检查Claude Code自身的配置(比如你的技能和Claude Code里的提示词);而内置的claude-api技能则专门针对调用我们API的业务代码。
这两个命令会扫描Claude Code当前工作目录下的所有内容——无论是技能、工具定义还是提示词,揪出上述反模式并直接帮你清理掉。这个工具在Anthropic内部很多人在用,在Twitter上也有点名气,操作极其简单,却往往能带来成本和性能的双重改善。
清理提示词能省多少钱?
来看一个例子。我搭建了一个包含约50个客户支持工单的合成评测集,起点是Opus 4.8,模拟迁移到Opus 5.5的过程。在迁移时,我人为注入了各种反模式提示词并分别测试效果。
核心结论很明显:即使带着这些反模式提示词,单纯从Opus 4.8升级到5.5,也能看到成本有所下降,性能略有提升(图表上的点向左上方移动了一点)。但如果在此基础上运行一次提示词审查,性能和成本还会再进一步改善。
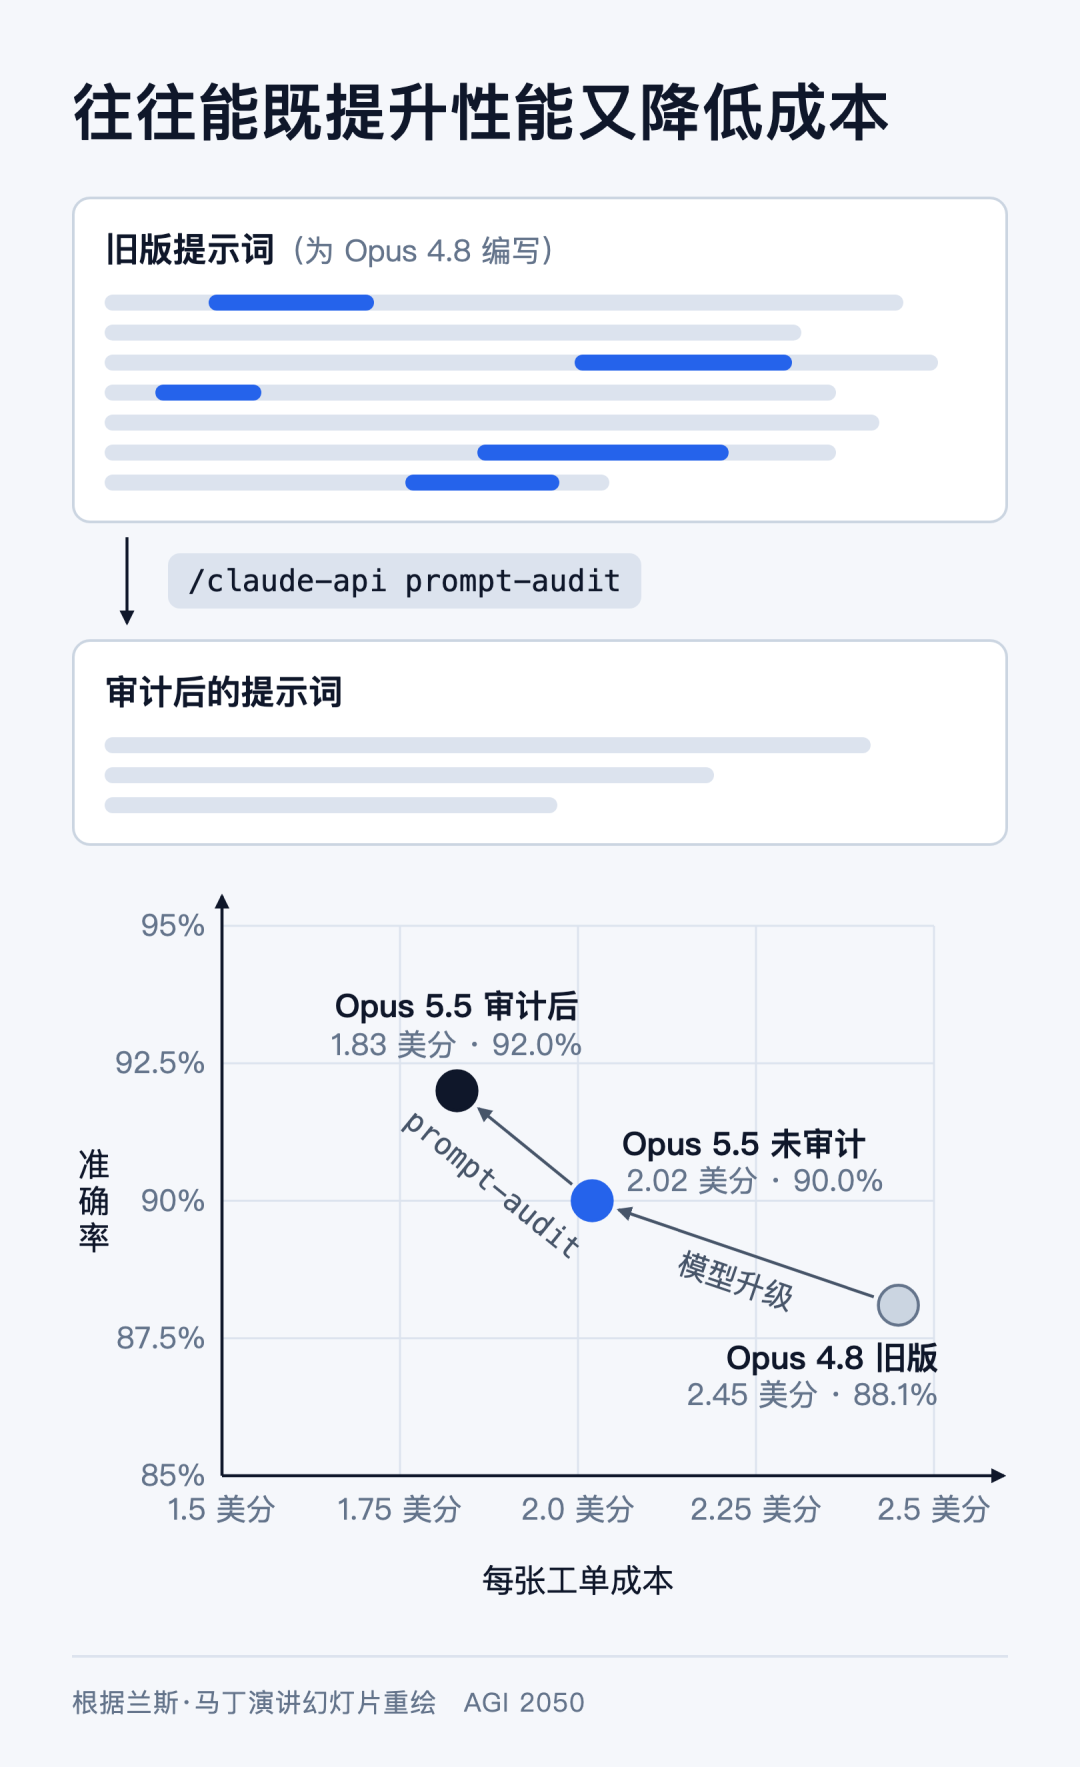
原因在于,这个命令清除了那些要求模型“反复验证”和“强行深度思考”的冗余指令,正是这些指令在逼着Opus 5.5白白消耗大量Token。这个简单的命令往往能减少Token消耗、省下成本;在矛盾提示词把前沿模型搞糊涂的情况下,还能提升性能。无论是调用API的业务代码,还是Claude Code自身的配置,我都建议跑一遍这个命令。
二、把提示词缓存用起来
第二点,务必用好提示词缓存。
拿智能体来说,一次任务往往要经历多轮交互。每一轮其实只新增了一点点内容,比如一次工具调用。大量的上下文在多轮对话中是不断重复的,你肯定不想为同样的内容付两次钱,这正是提示词缓存的用武之地。
命中缓存的Token计费大约只有基础价格的十分之一(不同模型略有差异)。重点在于,它不仅便宜得多,速度也快得多。因此在开发多轮交互应用时,重度依赖提示词缓存是必修课。
但这里有个坑:提示词缓存采用的是“严格前缀匹配”机制。只要前缀里变动了一个字节,整个缓存就会失效。所以在构建智能体或多轮应用时,必须格外小心,千万别在无意中破坏了缓存结构。
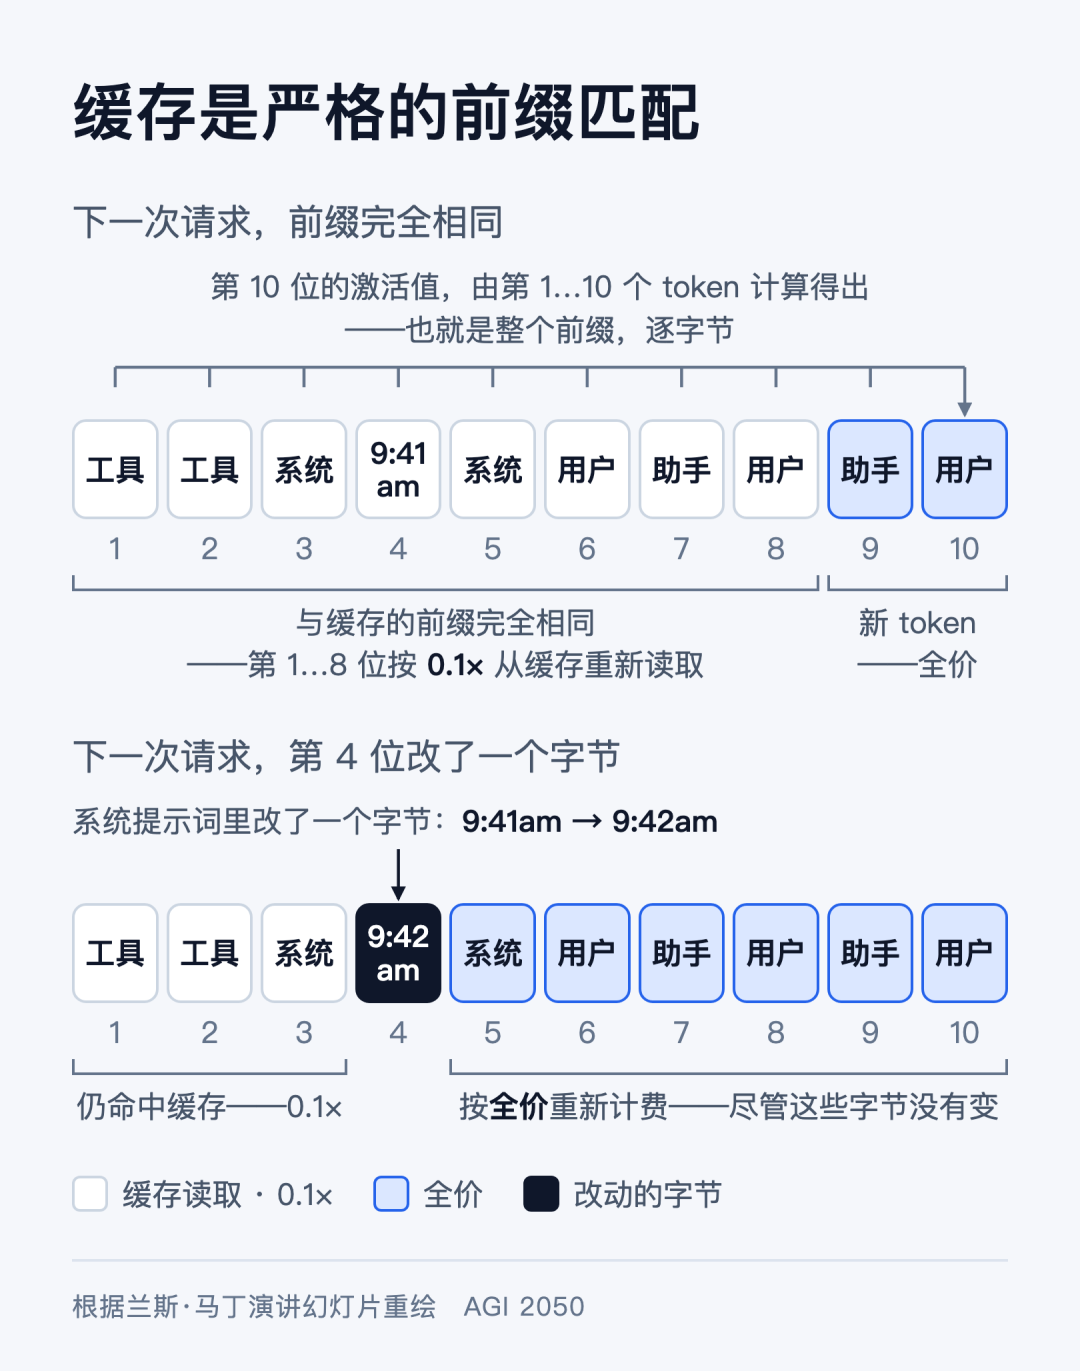
如果你在用Claude API开发应用,Claude控制台提供了直观的诊断工具,可以查看应用的提示词缓存命中率。在研发Claude Code时,我们就把缓存命中率当成核心指标死死盯住,因为这直接关系到整个产品的经济账。
那么,日常该怎么组织提示词结构呢?大体可以按这样的顺序来排:最前面放系统指令、工具定义等跨所有会话全局缓存的内容;接着是类似CLAUDE.md这种按项目缓存的记忆文件;然后是按单次会话缓存的会话状态;最后才是每一轮不断追加的消息记录。
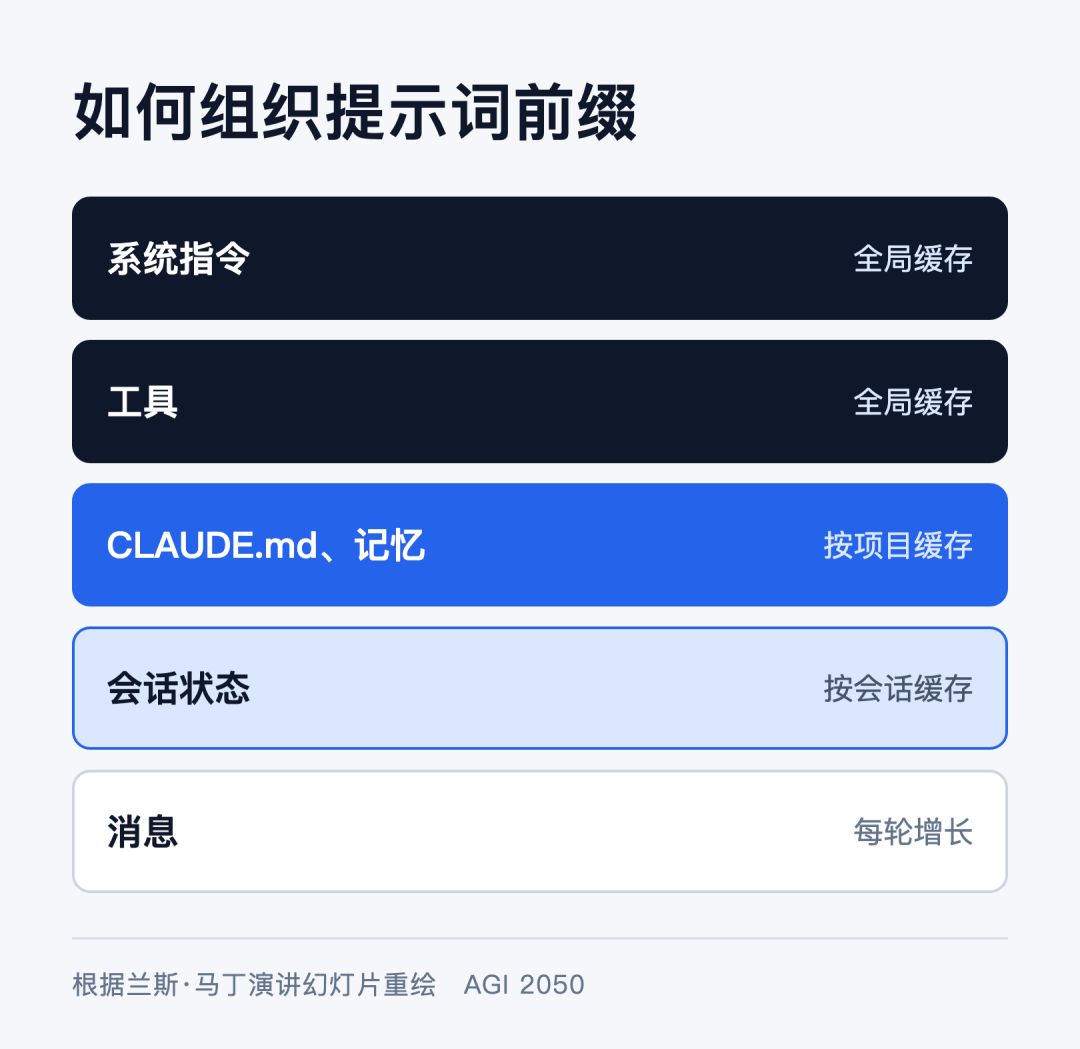
在Claude Code里,你可以直接针对API项目运行诊断命令。它会全面检查提示词缓存的使用情况,找出可以重组提示词结构的机会,从而把缓存命中率拉高。
性能基本不变,成本最高降72%
我和Claude AI团队的几位同事做过一个测试:拿这个命令去跑内部一批使用默认运行框架(指驱动模型运行的底层代码框架)的基准测试。结果发现,仅仅因为部分运行框架没用好提示词缓存,在性能没有明显变化的前提下,最高能省下72%的成本。
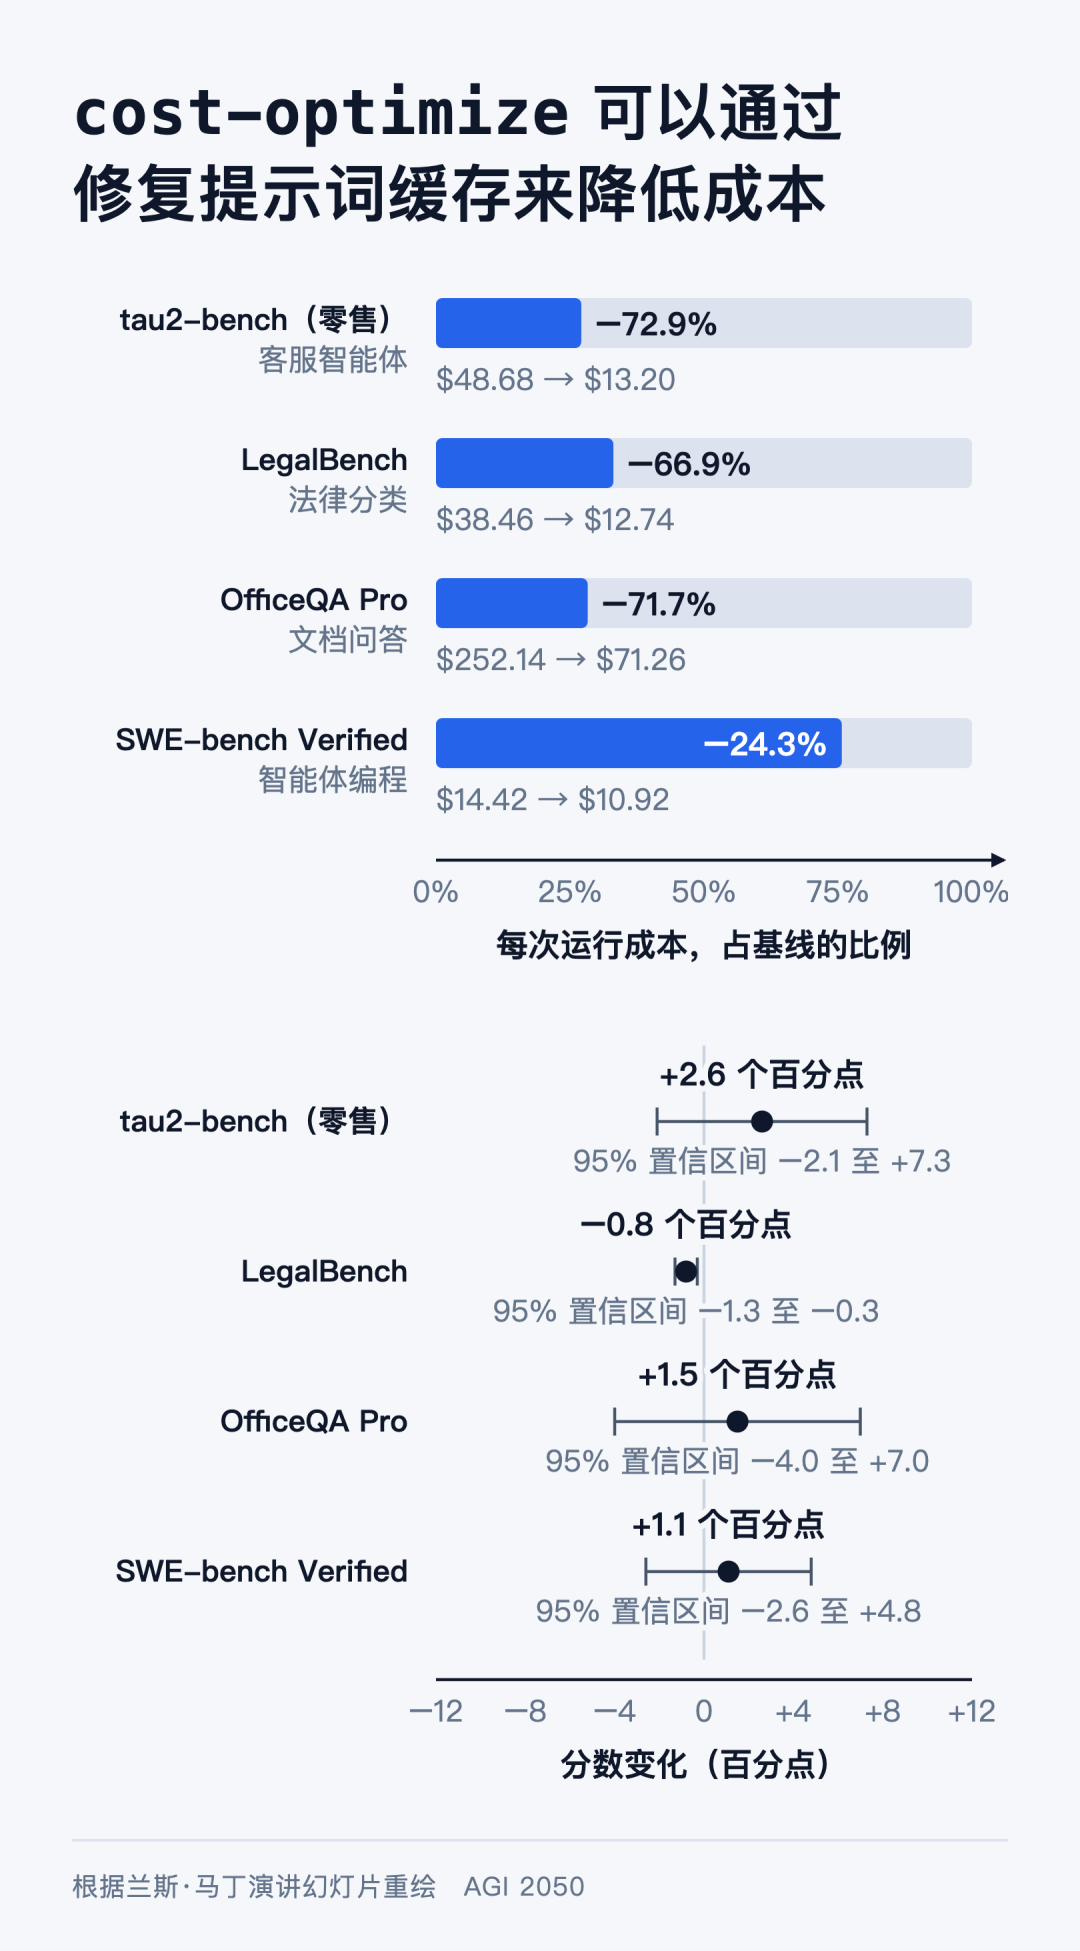
只需在API代码库里跑一下这个命令,它不仅会帮你深挖提示词缓存的省钱潜力,还会顺带检查推理力度设置和提示词写法。优化提示词缓存不会对模型表现产生任何副作用,省下来的每一分钱都是纯赚的。
三、设计一个让Claude能“拾级而上”的评测集
前沿代的Claude模型具备极强的自我纠错能力。只要给它一个结构良好的评测集,它就能顺着这个评测集不断进行“爬山优化”(指像爬山一样通过反复试错迭代,逐步逼近最优解的算法过程)。但这背后的前提是:评测集本身得设计得好,必须具备“可攀爬性”。
先温习几个优秀评测集的基本特征。如果把每次尝试消耗的Token数(代表思考深度)作为横轴,得分作为纵轴,从上到下画出大、中、小三个模型(对应Opus、Sonnet和Haiku)的表现曲线,一个健康的评测集通常应该呈现出四个特征:
第一,模型档次越高,得分越高;
第二,思考时间越长(消耗Token越多),得分越高;
第三,即使是最顶尖的模型,也依然留有提升空间,也就是说评测集还没有饱和;
第四,多次运行的方差要小,结果稳定。
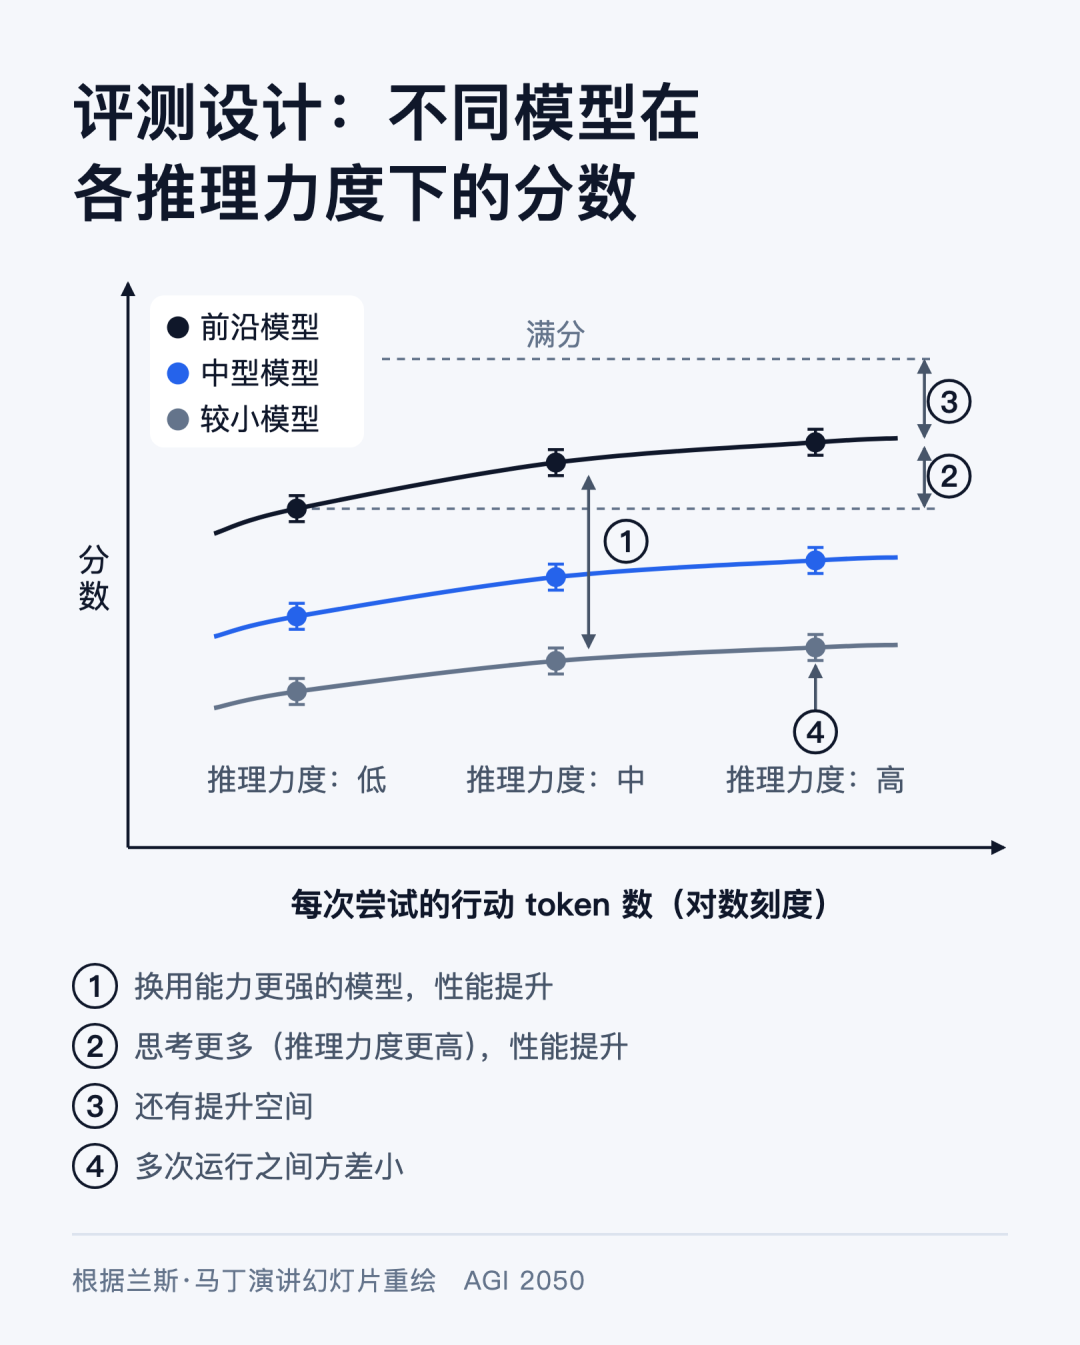
道理听起来很简单,但实际操作中却极容易翻车。我们见过太多热门评测集,里面充斥着大量表述含糊的任务,实际上压缩了前沿模型的提升空间。你辛辛苦苦建好一个评测集,表面上看距离满分还有20%的提升空间,但实际上是一堆含糊不清、本来就解不了的题,没有任何模型能做对。如果拿这种实际上已经饱和的评测集去跑自动优化,除了白白烧掉海量Token,什么也得不到。
为了解决这个问题,可以试试Claude Code里的/claude-api build-eval命令。这个工具对数据存储位置毫无限制,你可以把它指向任何现有的链路追踪系统。你只需要告诉它你想解决什么问题、你关注的是什么,并提供原始的运行日志,它就会运用上述原则,一步步引导你搭建评测集:给你看数据、看评测,还会和你一起核对打分器的评判标准是否合理。
四、自动“爬山优化”,但别掉进过拟合陷阱
一旦手头有了前沿还有提升空间、方差低、分数随模型档次和思考量如期上升的优质评测集,就可以开启自动“爬山”了。前沿Claude模型能够完全脱离人工干预,自主分析评测结果并持续迭代改进。
但这里潜藏着一个巨大的危机:过拟合(指模型过度迎合测试题目的特殊规律,导致到了真实环境里并不见效)。
举几个典型的反面教材。比如基准测试里恰好有一道题需要用到OCR(光学字符识别),为了拿分,自动优化程序就在代码框架里硬塞了一个OCR工具,但线上真实业务根本没这需求;再比如,优化后的提示词死死咬住测试集里的某些特定句式,一旦放到生产环境面对真实用户的表达,立刻原形毕露。你烧了一大笔钱跑爬山优化,测试集分数突飞猛进,结果一部署到线上毫无起色,往往就是因为优化过程完全迎合了评测集的数据分布。
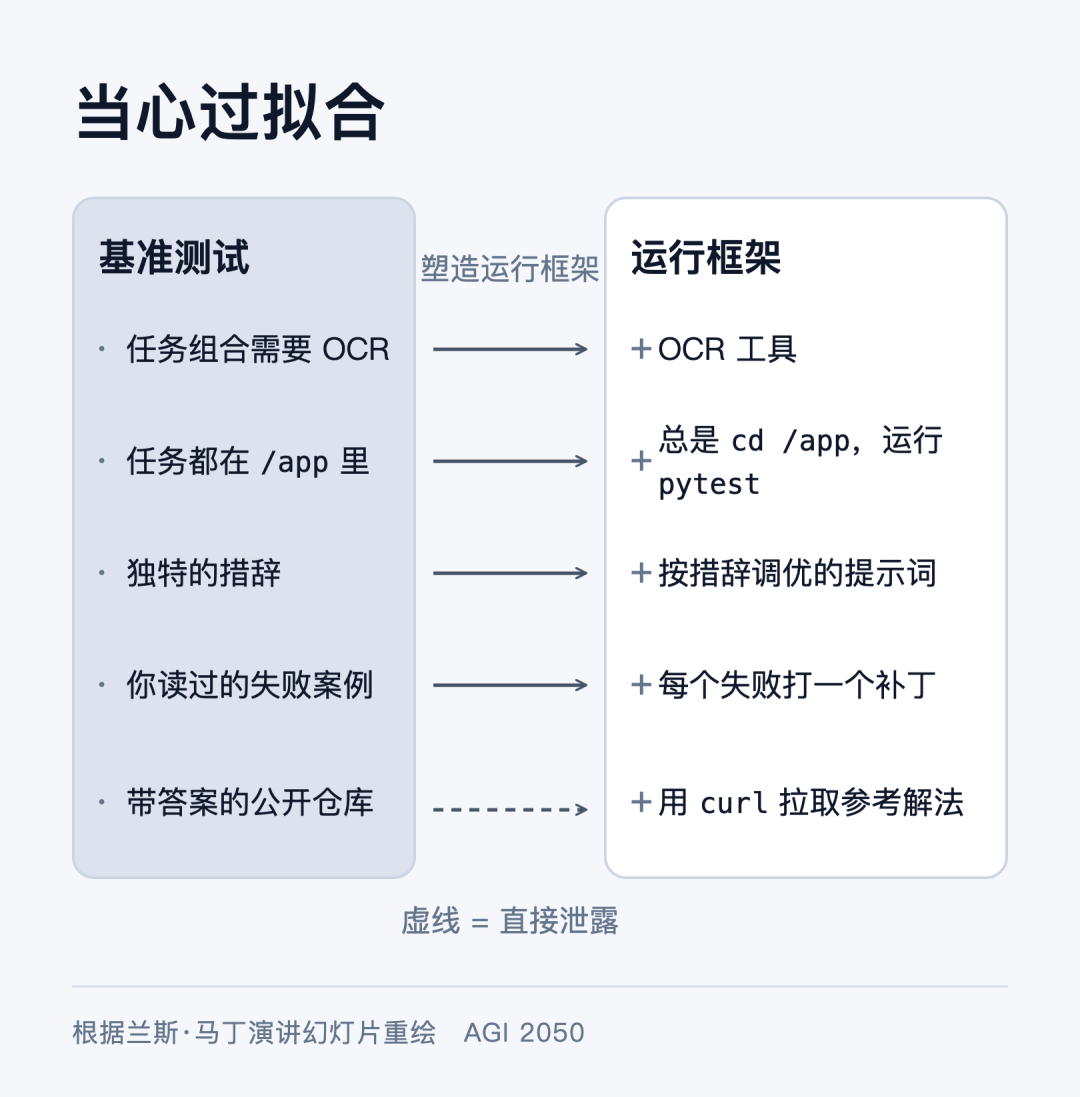
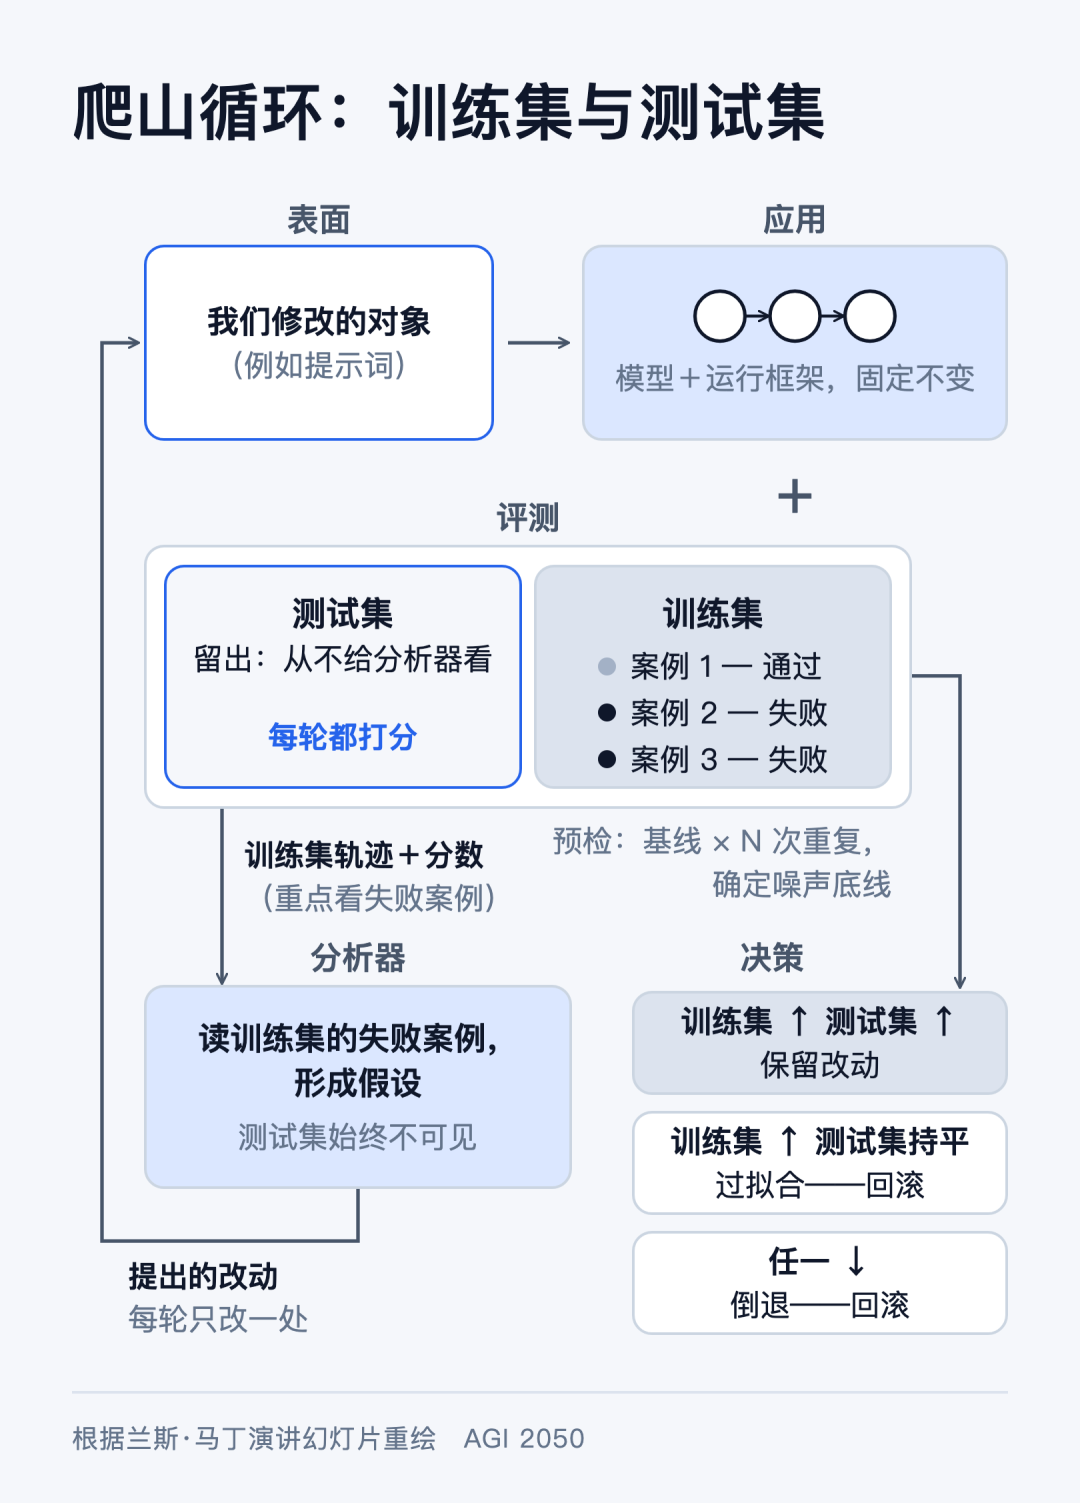
为此,可以在Claude Code里试试/claude-api hillclimb命令。它的核心防过拟合工作流借鉴了统计学里最经典的做法:将评测集拆分为训练集和测试集。在每一轮迭代中,Claude Code只被允许查看训练集里的失败案例,并据此反思、修改配置;它自始至终看不到测试集的题目。
每一轮修改后,系统会同时在训练集和测试集上跑分。这就提供了一个过拟合的早期预警信号:如果看到训练集分数一路高歌猛进,测试集分数却原地踏步,那就提示你可能正在过拟合。当然,工具不是万能的,人工审查和把控依然不可或缺,但这套机制能帮你检查优化成果是否真正适用于生产环境(前提是评测集本身建得好)。
实战案例一:让内置技能准确率从66%飙升
分享一个我亲手操刀的真实案例,对象就是前面提到的claude-api技能本身。这个技能的作用是让Claude全面掌握我们的API和SDK用法,所有回答必须严格遵循官方文档。
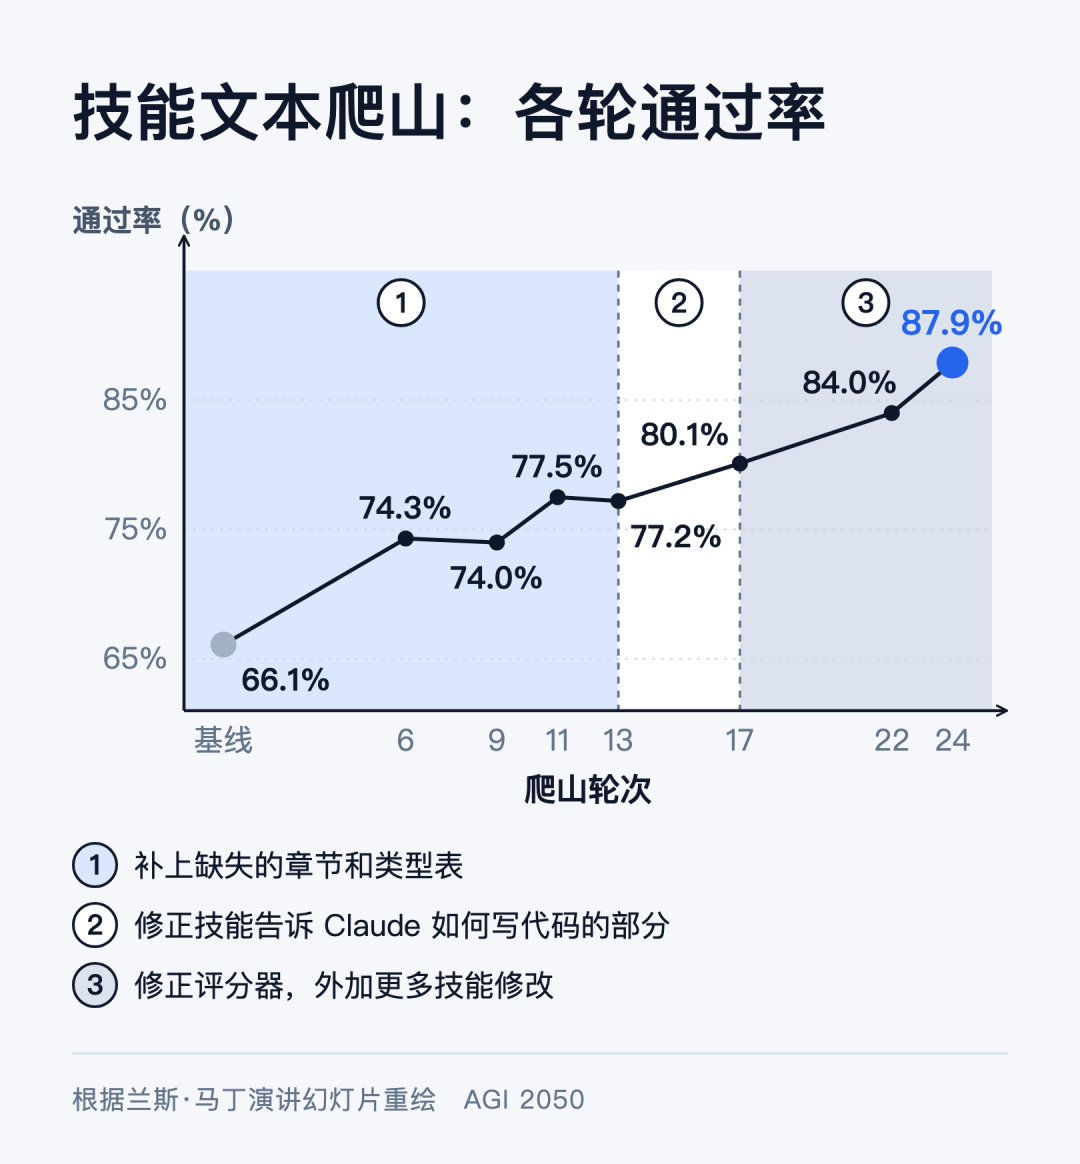
我基于官方文档构建了一个评测集,摸底测试发现,初始版本的技能准确率只有66%。于是我架起了一个自动爬山循环,把技能的文本文件和官方文档一并交给Claude Code,让它自己去对比评测集里的错题,排查技能描述到底在哪里曲解了文档原意。
最终,Claude完全自主地改写出了最恰当的技能说明文本,让评测得分实现了质的飞跃。这个案例很好地证明了,在评测集边界清晰、要修改的目标(比如纯文本格式的提示词或技能说明)足够简单直接时,放手让Claude自己去跑循环,往往能大幅提升效果。
实战案例二:向成本要效益,费用狂降90%
除了提分,客户们还特别喜欢另一个玩法:把爬山算法用来压降成本。
我在/claude-api hillclimb命令里加入了一套专门的指导逻辑。如果你下达的指令是“降低成本”,它就会在保证性能绝对不低于现有基线的前提下,自动去搜索确定能省钱的配置组合,搜索范围涵盖推理力度、模型档次以及提示词。
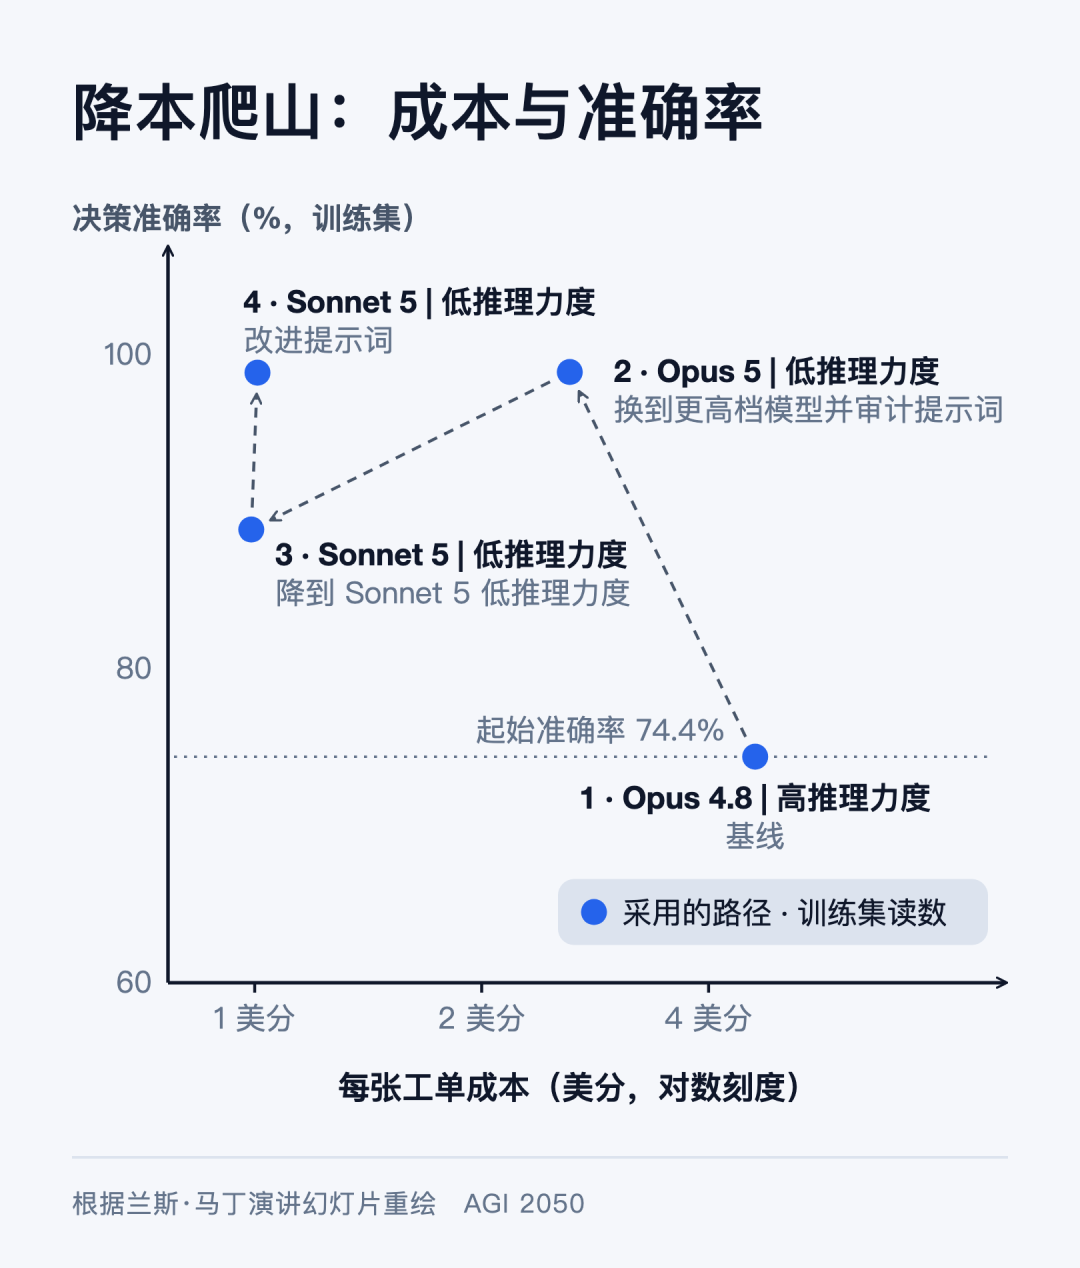
还是拿前面那个客户支持工单的基准测试举例。起点是Opus 4.8(高推理力度)搭配基础提示词。下达降本指令后,爬山程序开始自动遍历不同的“模型+推理力度”组合:
第一步,它尝试切换到Opus 5(低推理力度),结果性能大幅跃升,成本还微降了一点;
第二步,它自主尝试了Sonnet 5(低推理力度),虽然成本断崖式下跌,但性能出现了一定退化;
第三步,它转而微调提示词,成功把掉下去的性能又拉了回来。
一通操作下来,整个系统在完全自主运行的情况下,不仅性能比最初明显提升,成本更是暴降了90%。
这招最妙的地方在于,哪怕你手头的评测集已经饱和(分数已经没有提升空间),依然可以用得上。既然分数已经到顶,那就让爬山算法锁死当前性能,专心把成本往死里压。在搜索过程中,经常能发现一些很有意思的规律:比如用更聪明的模型搭配低推理力度,往往比用次一级的模型搭配高推理力度既便宜又好用。聪明人稍微动动脑筋就能漂亮地解决问题,消耗的Token反而比笨人抓耳挠腮半天要少得多。这个经验已经被我们直接固化到了爬山技能的底层逻辑里。
五、为连续运行数日的智能体打造可靠底座
要真正释放前沿模型的潜力,底层运行框架的设计同样至关重要。
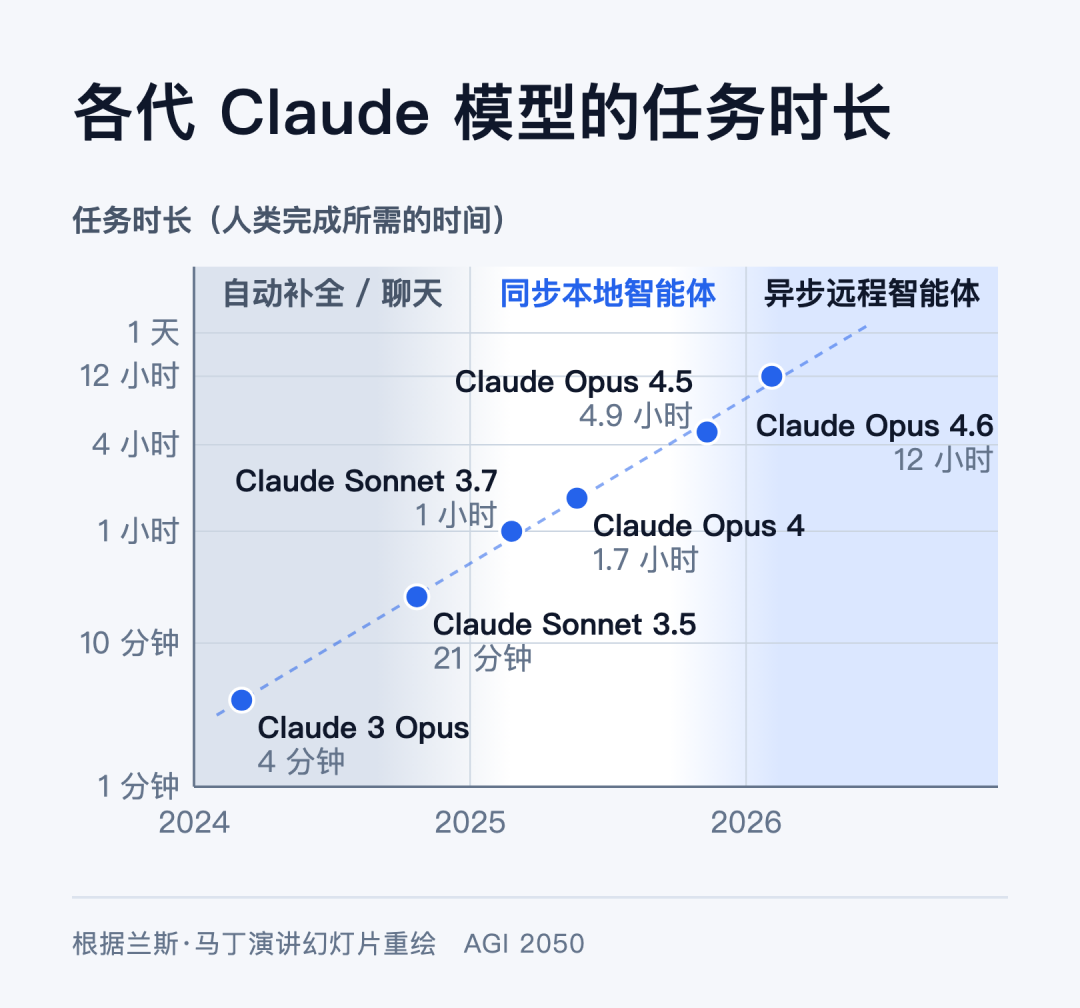
回顾过去几年大模型的发展轨迹,如果把时间作为横轴,把模型能独立完成的任务时长(换算成人类工作时间)作为纵轴,就能看到大家熟悉的METR曲线(METR是一家专注于评估AI自主能力的评测机构)。
在Claude 3 Opus时代,模型只能独立维持大约4分钟的有效工作,那时候能做的产品无非是代码自动补全或者简单聊天。到了2025年,模型能力越来越强,已经能承担大约一两个小时的人类等效工作,Claude Code也在这一年取得了显著进展。
而现在,我们正在跨入一个全新的阶段:模型单次任务的持续时间已经突破了一到两天,我觉得这大概已经超出了METR能衡量的范围。当模型能够连续不断地自主工作好几天时,对底层运行框架的考量会大不一样——你该如何保证它在漫长的运行过程中既安全又可靠?
托管智能体:把“大脑”和“双手”拆开
这正是我们推出全新API——Claude托管智能体的初衷。我4月写过一篇工程博客,核心理念只有一句话:将大脑与双手解耦。
逻辑非常直观:智能体的控制框架是“大脑”,而代码沙箱则是“双手”,负责实际编写代码和执行操作。这两者要分开。
为什么要这么做?设想你晚上睡觉前启动了一个智能体跑长线任务,结果半夜沙箱环境突然崩溃了。这非常让人沮丧:你会丢掉运行状态,丢掉会话日志,所有东西都没了。
为了应对长达数天的工作场景,我们将整个系统设计成了完全可恢复的架构:
首先,会话日志被独立出来,既不属于控制框架,也不属于沙箱,而是一个只允许追加写入的独立存储对象。无论控制框架还是沙箱挂掉,随时都能读取会话日志恢复现场。
其次,沙箱和控制框架本身也是可随时重建的。一个沙箱死了,可以重新启动一个新的;控制框架挂了,可以通过协调器重新拉起一个。
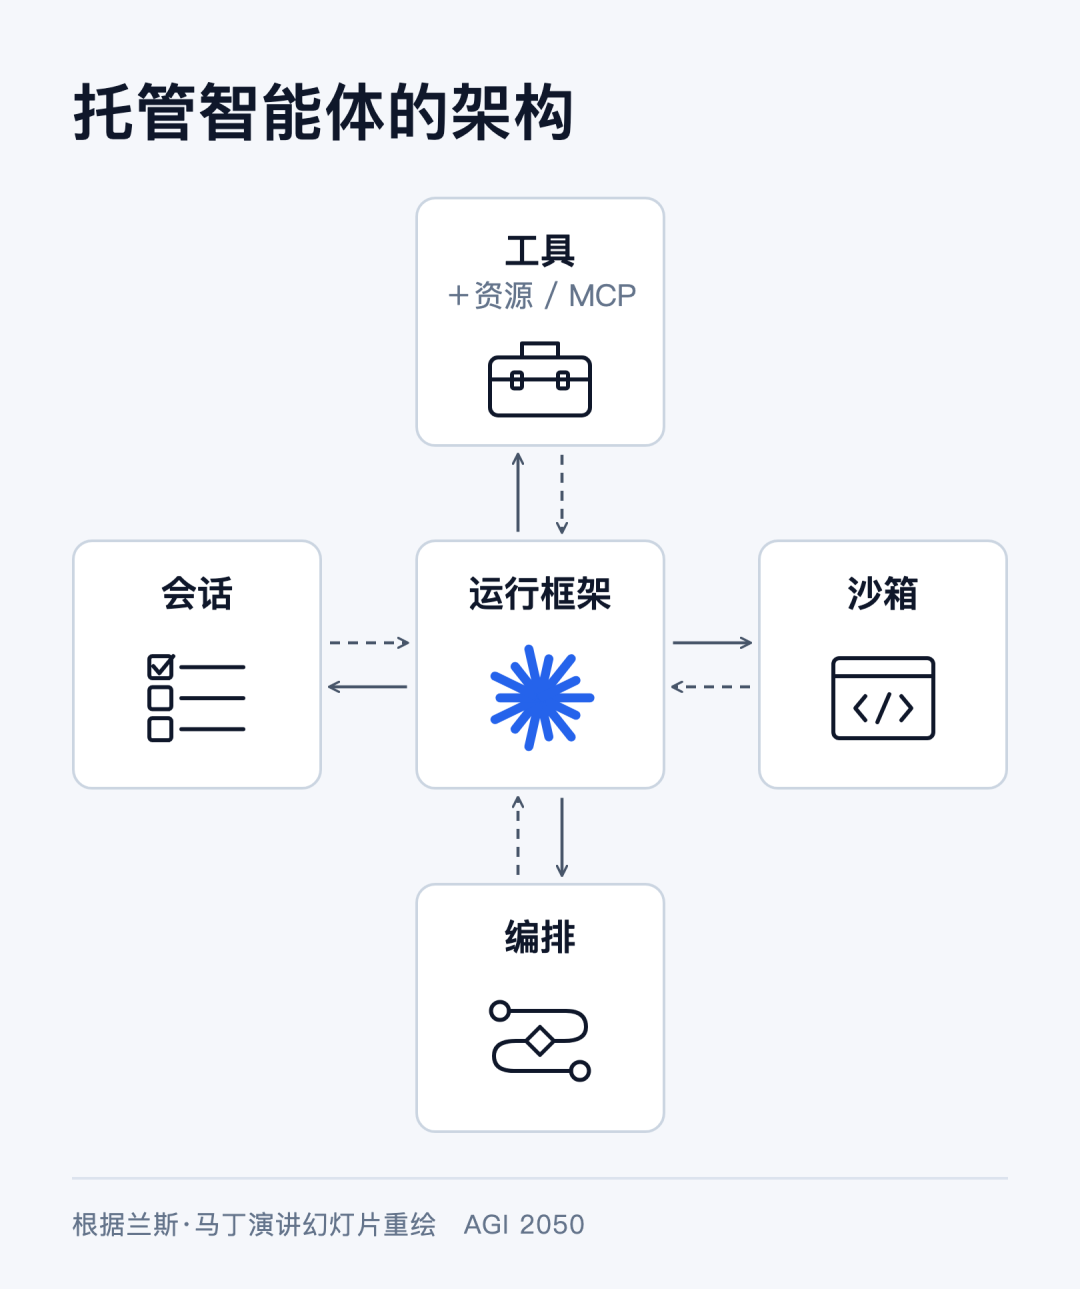
另一个命门是安全性。在托管智能体架构中,Claude永远无法直接接触到任何密钥。所有的API密钥和敏感凭证都锁在架构图顶部那个工具框里的“保险库”里。Claude在调用工具时可以引用这些密钥,但绝看不到明文。毕竟,让一个在后台连续自主运行好几天的智能体直接攥着核心机密,多少有点让人发毛。随着智能体的运行周期从几小时延伸到几天,也许很快会到几周,可靠性和安全性会变得重要得多。
我和同事CJ最近发布了一篇新博客,演示了如何用这套机制搭建一个自动化智能体。它可以定期抓取你指定的各类信息源,整理出上下文动态并自动推送到Slack。它把定时部署、Anthropic托管底层设施、密钥安全存储以及记忆等核心原语全部串了起来。想体验的话,直接在Claude Code里运行/claude-api managed-agents-onboard并附上博客链接,系统就会自动为你拉起整套教程和示例环境。
总结
想要真正解开前沿大模型的束缚,我们需要多管齐下:给提示词做体检;在构建长周期智能体时用好提示词缓存以控制成本;为长线任务设计高可靠、高安全的底层运行框架;同时在评测集设计和自动爬山优化上下足功夫。
当把这些拼图拼在一起,一种全新的工作方式就诞生了:你只需精心设计好一个评测集,把任务丢给高度安全可靠的智能体,让它自己跑上一整晚去做爬山优化,比如早上回来时,系统性能已经明显提升。这正是我身边许多Anthropic同事现在的日常工作状态——大家把越来越多的精力花在前端的“评测集设计”上,定义好问题,剩下的迭代优化全权交给Claude自己去跑。
现场问答
问:能利用人类反馈来进行自动爬山优化吗?另外,最适合从哪个模块开始跑优化?
兰斯·马丁:爬山优化的唯一前提是:你得有一个评测集,并且能给出明确的“好坏”评判信号。只要你能把人类的反馈转化成可供判断好坏的评测信号,拿来做自动爬山优化应该完全可行。
至于从哪里入手开始优化,纯文本模块通常是不错的起点,尤其是提示词和技能说明。原因在于,修改这两处会直接、显著地改变模型行为,调整范围高度可控,且与最终输出结果的因果关系极其明确。比如在优化claude-api技能时,测试任务就是直接读取技能文本来答题,两者紧密耦合。
相反,我也尝试过直接让它去优化智能体的底层代码框架,但那里会更棘手一些。每轮迭代改的都是大段代码,更难解读;而且代码逻辑千头万绪,很多修改可能根本传递不到最终的评分信号上,容易让优化过程迷失方向。这条路当然走得通,也有不少人做过,只是建议大家还是先从提示词或技能文本入手。
不过要注意硬币的另一面:提示词这类东西也非常容易过拟合。哪怕做了训练集和测试集切分,Claude依然极其擅长把提示词“扭曲”成某种刚好能迎合评测集的怪异形状。所以改提示词虽然见效快,但防过拟合的弦必须时刻绷紧。
问:对于没有标准答案的开放式任务,该如何设计评分标准?
兰斯·马丁:如果能用确定性的规则来判分,那自然是首选。但在开放式领域,这招失灵了。我的经验是:打造一套结构严谨、能让不同打分者得出一致结论的评分量表。
具体有四条实操守则:
第一,先过人类自己这一关。写出来的评分标准,你自己作为一个人类看过去,必须能据此判断并给文本打分。
第二,别用随意定的打分刻度。我见过太多人让模型“从0到5打分”甚至“1到10打分”,这种指令极其模糊,产生的噪音极大。要把标准切得干脆利落,最好直接用二元分类(通过/不通过)。如果考察维度多,宁可拆成好几个独立的二元判断题,也别搞一个笼统的十分制。
第三,跨模型交叉验证。拿同一套评分标准,同时让Sonnet、Opus和Fable去给同一批结果打分。如果三个模型打出的分数大相径庭,那就是个不好的信号。
第四,重复测试看方差。用同一个打分模型对同一批数据连跑几次,确保每次打出的分数高度一致,波动极小。
只要把这四点做到位,哪怕是评估一段文字写得好不好这种非常主观的任务,用大模型当裁判也能做得相当不错。
另外,成对比较也是一个利器。无论是人类还是大模型,让你单独给一个网页打0到5分往往很难抉择;但如果把两个网页并排摆在一起,问你“A和B哪个更好”,判断起来就容易太多了。如果业务场景允许,用两两PK的方式来替代绝对打分,是处理模糊评分的有效办法。
问:如何确保评测集的数据分布能真实反映线上生产环境?
兰斯·马丁:所谓保证数据分布一致,核心就是确保你挑进评测集里的那批样本,真正代表了线上业务最关心的核心场景。
这里要特别警惕一个常见误区,叫作“对抗性采样”。大模型的智力分布是呈“锯齿状”的,如果你在构建评测集时,专门挑某一代模型(比如Sonnet 5)做错的题目往里塞,就会造出一个完全贴合Sonnet 5能力短板的特殊评测集。等你将来升级到Opus 5时,可能瞬间就全做对了,因为这类题只是某个模型的短板,换了模型就不成立。
通常比较好的做法是:从业务的第一性原理出发,结合你对线上真实数据的观察和直觉,去挑选那些本质上就难或者有意思的案例放进评测集,而不一定全从某个特定模型的错题里抽。
问:自动爬山优化一定能收敛吗?如果卡住了怎么办?
兰斯·马丁:绝对不保证一定能收敛。在实际测试中,爬山程序卡在半山腰上不去的情况屡见不鲜。
为此,我们在爬山技能里专门设计了一套兜底机制:如果连续好几轮迭代分数都纹丝不动,程序就会暂停盲目尝试,转而把剩下的错题全部归拢起来进行聚类分析。很多时候,用户没用/claude-api build-eval仔细打磨评测集就直接开跑了,最后剩下的那20%可能全是指令含糊、或者评分器本身有问题的题。爬山程序卡住,往往不是因为Claude能力到头了,而是评测集本身有硬伤。
像前面我演示的那个把技能从66%提升上去的案例,中间第二阶段其实就卡住了。当时工具自动对剩余错题做了聚类,揪出了一批表述含糊的测试题并进行了重写,然后接着往上爬。
问:推理力度这个参数到底该怎么选?为什么说“强模型+低力度”反而更省钱?
兰斯·马丁:如果你手头有现成的评测集,最省心的办法就是直接交给/claude-api hillclimb工具去自动寻优。它的搜索遵循一个很简单的原则,而且这个原则多半是成立的:更强的模型搭配低推理力度,往往比次一级的模型搭配高推理力度更节省Token,因而总成本更低。
如果还没有建好评测集,日常凭经验配置时,我的核心建议是:优先尝试“顶尖模型+低推理力度”(比如Opus 5.5设为低推理力度),不要选medium,直接从low开始试。
这背后的原理是什么?“推理力度”参数本质上是在告诉Claude:“面对这道题,你要花多大劲去思考。”这不是一个死板的Token数量硬上限,而是一种思考深度的引导。哪怕你设为高力度,遇到极其简单的问题,Claude也不会傻乎乎地硬凑一堆思考Token;但一旦遇到前沿的复杂编程等难题,不同力度之间的Token消耗差距就会拉得很大。
当你用一个基础智商更高的模型并设为低力度时,它站在更高的智能基线上,思考时花的Token更少;反之,如果你用一个单价看似便宜的次级模型(如Sonnet 5),却把推理力度拉满到High甚至Max,它就会在后台花大量的Token去反复思考。算总账的时候,单价高但消耗较少Token的聪明模型,反而可能比单价低却疯狂烧Token的模型更便宜。很多人习惯一上来就把推理力度拉到最高,那简直是吞噬Token的无底洞。从“强模型、低力度”起步,不够用再往上调,这往往是性价比的甜点区。
问:前面提到的提示词审查,清理掉那些旧习惯后,对老模型或者小模型(如Haiku)也同样适用吗?
兰斯·马丁:关于模型代际的界限,并没有一条非黑即白的分割线。有一点是肯定的:像5.5系列这样的最新前沿模型,绝对不再需要那些“一步步思考”之类的旧套路了。如果往回倒推,大约是从Opus 4.5那个阶段开始,这些辅助提示词的作用就已经在逐渐消退了。所以只要你正准备把业务迁移到最新的Opus 5.5,直接跑一遍清理命令准没错。
但如果迁移的目标是Haiku这类轻量级模型,情况确实会有些微妙。Haiku也许没那么自主,也许需要多留一点引导词,不过我也不确定,只是随口一提。好在我们的审查技能里内置了一些针对不同模型的说明,它会识别你当前调用的是哪款模型,并据此调整清理策略,不会一刀切。
问:在上下文工程方面,有哪些真正管用的架构设计?
兰斯·马丁:谈到上下文工程,我觉得“递归语言模型”(RLM)的思路很好;对可靠性很重要的一点,是把“大脑”和“双手”解耦,这也是我们在托管智能体中落地实践的方案。
核心思想是:把上下文变成一个独立于模型和控制框架之外的客观存储对象。
想象一下传统的做法:你把所有的对话历史都塞在一个消息列表里,接着做一次摘要压缩;如果没有另行备份,原先那些细节记录就消失了,再也找不回来。而在长周期任务中,你很难知道哪些内容将来会变得重要,做压缩时也说不准以后还要不要回头查那段上下文。
按照RLM的思路,我们将完整的会话日志独立存储在外部。哪怕模型当前的上下文窗口做了压缩,底层的完整日志依然毫发无损。我们为控制框架配备了专门的检索工具,一旦模型在后续工作中觉得需要回溯某个历史细节,随时可以像查数据库一样去重新审视和调取那份独立的日志。这种“状态外置、按需检索”的架构,是我觉得对可靠性、可恢复性很有用的一个办法,对长周期智能体尤其如此。
资料来源:AI Engineer纽约大会工作坊,Anthropic技术人员兰斯·马丁(Lance Martin)演讲《Your Old Prompts Are Making Claude Worse》及现场问答,2026年10月12日录制、11月6日上线,https://www.youtube.com/watch?v=ys6YQ2yfBpM