本文来自微信公众号: 智源社区 ,作者:智源社区,原文标题:《专访普林斯顿刘世隆丨人类是超强 Router,Agent 只是刚起步》
当开放世界检测模型Grounding DINO在Hugging Face上的月下载量突破两百万次,成为全球开发者广泛使用的工具时,它的核心作者刘世隆,正站在计算机视觉与具身智能的交汇点上,思考着AI的下一步。
这位即将入职哥伦比亚大学担任教职的青年学者,本科从工业工程跨界计算机,靠打比赛练就了扎实的工程底子。从博二提出DAB-DETR,到博三做出刷榜COCO的DINO,再到将Grounding DINO落地为开源爆款,他完成了视觉检测领域的扎实跨越。ChatGPT问世后,他转向多模态Agent;在普林斯顿做博士后期间,他全面聚焦自进化智能体,提出了Alita等框架,并通过博客为领域内模糊的RSI概念建立了清晰的“三层分类法”(输出层、框架层、模型层)。
当模型的泛化能力成为普遍追求时,他却直言坚信统计学习理论,认为不应苛求完美的泛化——“干任何事情都是不断朝终点搜索的过程,只要评估能减少搜索分叉就有价值。”在他看来,走向具身AI并非单纯堆砌模型规模,而是需要直击虚实鸿沟,寻找真正务实的破局点。
回看他的研究路径,核心其实很纯粹:不盲从宏大叙事,只用底层信念引导研究,再把研究做成对大家有用的产品。
未来CV与Robotics该怎样结合?Agent应该依据什么判断自己真的进步了?做机器人专有模型的意义是什么?在这篇深度专访中,刘世隆将回顾他从计算机视觉(CV)代表作起步,一路延伸至具身AI的研究轨迹,深入探讨自进化智能体(Self-evolving agents)、世界模型(World Model)、以及Agent在科学发现中的应用。
采访&编辑:梦佳吴柯伶熊宇轩
要点速览
研究路径与转折点:本科跨界工业工程,靠打比赛锻炼工程能力;在IDEA实习确立视觉检测主线;目前将研究核心转向自进化智能体(Self-evolving),并明确以机器人与科学发现作为核心落地场景。
代表作三部曲:从DAB-DETR入门,到DINO引领方向,再到Grounding DINO落地为产品,完成了从“探索科研”到“引领方向”再到“实用产品化”的三次跨越。
告别self-evolving泛化执念:不应该期待robot在适配一个极小的domain-specific benchmark的同时,还保持一定的泛化能力。基于统计学习理论,泛化执念需要被打破。
人类是超强Router:在复杂任务中,决定“什么时候做什么、把任务交给谁”需要极高的智能。人的路由调度(routing)能力远强于模型。怎么做一个更好的Router,是下一步AI要大力提升的关键方向。
World Model的细分闭合属性:World Model最大应用场景在一些非常niche的领域,下围棋也好、拧魔方也好,它可以完全模拟状态,拥有更好的搜索能力与搜索效率,甚至可以超越大模型。
AI赋能科学发现:科学发现极高的容错率契合AI特质。但其壁垒在于:物理环境(Wet Lab)验证困难,且大量核心知识属于极难被formalize的隐性直觉(“老师傅手感”)。
底层信念驱动研究问题:找问题基于底层信念:从底层逻辑推演“什么可做、什么不可行”,并基于对未来趋势的判断走在前面,做研究就会变得非常容易。
智源专访栏目意在展现行业顶尖技术研究者和创业者的研究经历和故事,记录技术世界的嬗变,激发当代AI从业者的创新思维,启迪认知、关注突破性进展,为行业注入灵感光芒。本次专访为总第43期。
简介:刘世隆,普林斯顿大学人工智能实验室(Princeton AI Lab)Peretsman Scully博士后研究院(A12 Fellow),将于2027年秋季入职哥伦比亚大学电气工程系任终身轨助理教授。曾先后在IDEA Research、微软雷德蒙德研究院、NVIDIA Research实习,并在博士毕业后于字节跳动Seed担任研究科学家。其研究长期聚焦于计算机视觉、自进化智能体与面向具身AI的世界模型。曾以第一作者或核心作者身份,在CVPR、ECCV、ICLR等顶级国际会议和期刊上发表多篇高影响力论文,谷歌学术引用超过24,000次,相关开源项目在GitHub累计获得超过30,000颗星。其代表作包括开放世界检测模型Grounding DINO(Hugging Face官方模型月下载量超200万次)、DINO系列检测模型、多模态智能体框架LLaVA-Plus、自进化智能体Alita,以及空间推理基准CubeBench等。
01
比赛中积累工程能力,押注Agent Self-Evolution
Q1:您本科就读工业工程专业,博士转向计算机视觉,学术生涯中有哪些转折点?
刘世隆:我本科在清华工业工程系,在谢小磊老师组里做了一些医疗优化相关的项目,在软件学院金涛老师组里又做了一些时序分析的工作,在高跃老师组里参与过一些关于硬件的项目。但我当时投入科研的精力相对较少,也没有什么好的成果。
保研时我进了计算机系朱军老师组,同时一直跟着IDEA研究院的张磊老师做研究,张老师也可以说是我的co-adviser。在大四上学期,我对命令行、代码规范都不是那么熟悉,基本上在积累一些工程经验。现在代码都是Agent写的,但当时是非常重要的一件事儿。我还参加了一些deepfake detection类的比赛,我觉得打比赛培养了我的工程能力。也是从那时候起,我开始做一些视觉的东西,以及神经网络深度学习的工作。
Q2:在您转变方向的这一过程中,有什么对您影响很深的人吗?
刘世隆:我真正开始做第一篇工作,是大四升到博士一年级的暑假。那个时期开始频繁地和张磊老师交流,一起做了无监督的部件分割,这在当时是一个比较小众的领域。我们运气不错,做了一段时间之后,我发现可以改进方法来提升性能,设置一些新的setting。我们从暑假做到了当年的12月,投了一篇CVPR,运气比较好就中了。可能和现在比起来不算什么,但当时我还挺满意的。这些都是比较早期的工作。
21年博一结束之后的暑期,我去了深圳IDEA研究院实习,我真的特别感激张磊老师,我觉得他真的算是我科研的领路人。他当时非常认真,手把手地教我做科研、找问题、设计解决方案,甚至亲自帮我看代码,一行一行debug。我在IDEA实习的时候,开始沿着Transformer-based detection做,算是找到了我博士期间的主要方向。
Q3:如何确定研究兴趣?如何从目标检测开始转向做Agent?
刘世隆:2023年ChatGPT出来了,我开始思考下一步该怎么走。当Grounding DINO成了开放世界目标检测领域的一个主流的工作之后,我觉得这个领域的上限有点受限了。真正的多模态、大语言模型才是最有价值的,它们会更加通用和泛化。当时我正好在西雅图微软实习,就和mentor李春元以及杨建伟、程浩一起做Agent。我们当时先从工具调用入手,发现它潜力很大、下游应用场景也很好。做完这一篇之后,2024年暑期我去了NVIDIA实习。为了接触更多的业界经验,我也去参加了一些多模态、大语言模型的大规模训练。
2025年博士毕业之后,我在想我以后要做什么,最后觉得还是更喜欢学术界的环境,所以就到Princeton来做博士后了。做博士后期间,我回顾了之前做的三件事:detection、multimodal agent和foundation model训练。我觉得在学术界最有前景的就是Agent,所以在Princeton,我们围绕如何让Agent实现self-evolution做了一系列工作。
Q4:拿到教职以后,目前最关注的研究方向是什么?
刘世隆:今年年初我开始找教职,运气比较好,拿到了Columbia的offer。现在我也在规划之后要怎么做,主要关注这三个方向:
1.self-evolving。我觉得它还有非常大的设计空间,并且和RSI有非常多的重叠,是一个可以大有作为的地方。
2.robotics。我们最近做了很多robotics的工作,包括embodied RSI和WAM,无论是world-action model还是agentic robot learning,都有所涉猎。这让我相信,self-evolving agent如果用在robot learning上会是一个非常有前景的东西。
3.与physical AI结合。physical里比较有价值的一个方向就是scientific discovery,我们要做agents for scientific discovery。
所以我之后要做的,是以Agent本身的self-evolution为核心,下游应用一是robotics,应用二是scientific discovery。
02
三次跨越:DAB-DETR、DINO、Grounding DINO
Q5:您能介绍一下在计算机视觉领域的代表作吗?
刘世隆:博二的时候,我们做了DAB-DETR。当时张磊老师非常有远见,关注到Transformer-based detection这个方向很有前景,所以让我们去做。我们入场时虽然有一些人在做,但整体竞争还不像backbone设计那么红海,某种意义上还是一个蓝海,我们就可以在里面做一些贡献。当时通过一系列改进,和collaborator也做出了DN-DETR。到博三,我们把很多工作综合起来push SOTA,并用大规模预训练做出了DINO,刷到了当时COCO榜单的第一名,真正开始在这个社区有了一定影响力。
博一暑假到博三,我们做出来DAB-DETR、DN-DETR和DINO这三个工作,终于把Transformer-based detection做成了一个主流任务,改变了大家对这个领域的认知,引领了这个方向。
DINO做完之后,我开始做多模态检测,先是做了一篇DQ-DETR,后来影响不太大。下一篇就是Grounding DINO,这篇可能就是我现在影响力最大的一篇工作。做这篇工作的主要动机是想要scaling up。于是从22年开始,我们花了近一年时间去搞数据、做训练,最后做出来的成果不仅是SOTA,而是落地成了一个实用的产品。
这些作品大概代表了我的三次跨越:1.我开始知道怎么做科研;2.我们做出来一系列工作去引领方向;3.我们真正能做出来一些实用的产品。
图注:刘世隆GitHub主页
Q6:AI正从“识别眼前有什么”走向“通过Agent与物理世界交互”。未来CV与Robotics结合的趋势是什么?
刘世隆:ChatGPT出来之后,为了让我们之前做的Grounding DINO能够被调用,我们做了一个framework,给了它一些和人对话的接口,也就是LLaVA-Plus。但后来我们发现Agent非常强,是一个能做很多事情的通用接口,于是就在Agent这条路线上投入了更多精力。
现阶段,VLM的一个好处是它真正统一了输入输出的模态。Scaling是最重要的,它有几个要素,一是数据要好,模态统一了就可以加更多数据;二是模型结构要足够Scalable,而Transformer就是非常可扩展的结构。所以,其实是架构和数据的共同作用,我们才能见证这么多的快速发展。
再往前看,Robotics最大的问题也是数据,所以大家都在采真实数据。虽然我觉得纯仿真数据是不行的,但我们也需要更多仿真数据来帮助做一些方法上的探索。还有一点是,需要让Agent的能力去帮助robotics的能力,未来的一个重要方向就是agentic robot learning。
图注:LLaVA-Plus介绍
Q7:目前视觉Agent工具调用领域的瓶颈是什么?如何解决这些瓶颈问题?
刘世隆:最大的瓶颈是学术界训不动模型了。我们也用RL训了一些模型,但非常耗资源,只能做一些小规模实验。对工业场景来说,不训预训练模型,直接拿预训练模型来用,那“怎么用得更好”就是一个重要问题。如何解决这个问题,主要有两个方面:
第一点是self-evolution,让Agent随着任务进行演化、积累skills。比如我们之前做的Alita就是在积累skills。
另外一点是Agent的设计。不一定是multi-model agent层面,更底层的coding agent本身也有非常多的细节。我们最近刚发的Physics of Coding Agents Part One,就是在研究coding agent怎么去设计。举个最简单的例子,让coding agent改一个代码,至少能找到三种不同方式,但不同的模型在这三种方式上的表现差距非常大。比如用行号改、用search改,或者混合着改,最后的结果差不多,但token消耗量可能相差2到5倍。
在一些Agent自身都不会关注到的、需要人去关注的细小地方,还有非常多能够做研究的空间。就像当年在ResNet里加一个Residual路径一样,有很多细小问题值得被优化。现在大家用Agent做科研,往往会忽略掉这些非常细的领域。
03
告别泛化执念,重构自进化智能体评估规则
Q8:self-evolving agents和RSI的区别主要是什么?
刘世隆:这两个词在很多场景下是可交换的,取决于大家怎么定义。比如工业界的初创公司特别喜欢提RSI,他们会说是让Agent不断去改自己的output,来实现自我演化。
在我之前的博客中,我们把自进化分成了三个layer:
1.输出层。这是最上面的layer。比如写论文或写代码时,Agent不断改自己的输出结果。
2.框架层。Agent本身的设计也是可以改的,因为它自己就是一个code。Agent可以不断改自己的harness来做这些skills,或者improve自己的prompts。
3.模型层。也就是最底层的base model,模型本身的parameters也是可以被调整的。
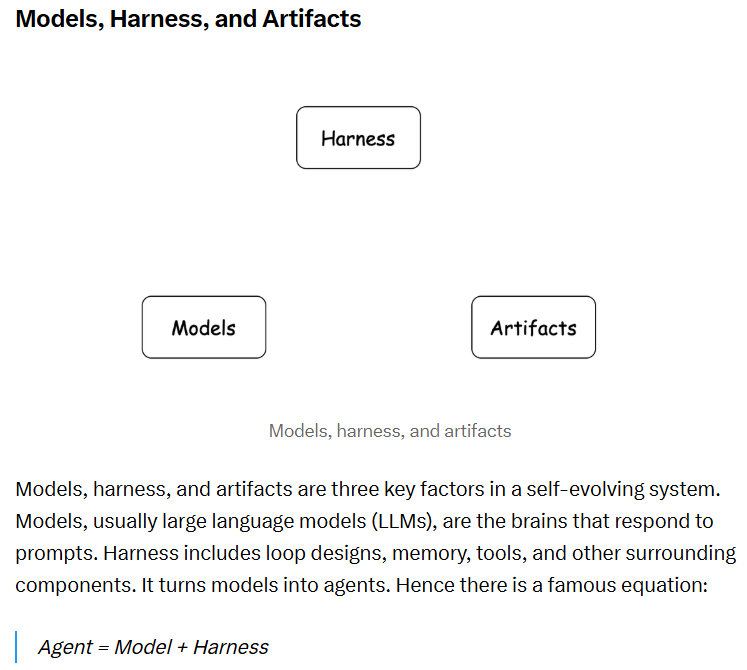
图注:刘世隆《A Taxonomy of Self-evolving Agents》博客部分内容
不同人提到RSI或Self-evolving时,可能指的是这三个层级里的不同东西。这两个词有非常强的重叠,我更关心的是它到底是在哪里做进化。
Q9:Agent应该依据什么判断自己真的进步了?
刘世隆:evaluation一直是个很重要的事情。比如当我们遇到一个问题,第一步就应该先定evaluation怎么做、设定benchmark。ImageNet之所以伟大,就是因为它确立了标准。这也是张磊老师当年教给我的重要经验。早年做CV研究的人都在改结构,因为当时evaluation是被定好的,它的重要性被模型架构的光芒盖过了;而现在这个领域变得更加复杂,哪个evaluation是最好的,变得不那么清晰了,所以会有越来越多的paper去定evaluation。
怎么设定好的evaluation是和问题强相关的,有不同问题,就需要不同的设计方法。看最后成功多少是个很好的指标。以做机器人执行为例,应该去看最后的成功率;coding agent的话,就是去看算法测试。但在现实世界里,很多时候拿不到最终的reward,那用proxy task来做也是一个方法。就像大模型不能百分之百正确,我们也不能相信一个evaluation能够百分之百完美。干任何事情都是个从原点走向终点的搜索过程,就像树一样在不断分叉。只要这个evaluation能够帮我们减少分叉的条数,减少搜索到终点的时间,那它就是有价值的。
确定evaluation之后的下一个问题就是,我们不应该期待robot在拟合到一个特别小的domain-specific benchmark的同时,还保持一定的泛化能力。我相信统计学习理论,所以我不相信泛化这个事情。从实用主义的角度来说,假设一个benchmark做得特别好,那让Agent在上面过拟合就好,未必要保证它在其他方向的泛化能力。OOD这个问题几十年了,也没有真正被解决掉过,甚至没有看到一点成功的迹象。
Q10:DeepJEPA发现,实际上多算几步并不一定带来更好的行动。真实世界是不断变化的,模型应该怎么判断什么时候继续推演,什么时候采取行动?
刘世隆:其实之前在Segment Anything的时候,大家可能就发现,backbone不一定要用最后一层的feature,用中间的feature会表现得更好。有些人解释说,可能前面几层做表征,后面几层去适应task,所以表征最好的那一层未必是最后一层。我觉得这个解释在某种意义上也是合理的。
至于什么时候输出、思考到什么地步,和现在大模型的思考过程、和Looped Transformer都可能有些关系,很多时候想得到最精确的结果就是要做实验。
另外就是对这个任务难度的理解,有点像我们说的routing,像我们做过的EEVEE、Alita这些工作。routing其实是件很难的事情,你让模型决定什么时候做什么,哪个任务交给谁,需要非常多的信息和智能。而人是一个非常强的router。人遇到问题之后,知道这个问题找谁可能是最好的,人的routing能力是远强于模型的。怎么做一个更好的Router,这是下一步AI要去大力提升的方向。
【追问】现在出现了Jev这样的决策模型,您认为它是实现Router的好方式吗?
刘世隆:Jev是一种efficient版本的模型,它在架构上可能是基于某个开源的LLM fine tune的,本质上还是LLM,最大的好处就是可以把一些subset抽象出来。这世界上有非常多复杂的任务,所有任务都用一个模型去解,是一个很浪费的事情,尽管那个模型可以解得更好。把不那么需要复杂推理过程的任务交给一个比较简单的模型,确实可以认为是一种router。
未来这种模式会越来越多,就像Expert agent一样,把高频、易于聚合的任务抽象成专门的Specialized Agent。我相信,未来一定是属于Multi-agent的。
04
跨越虚实鸿沟,物理AI,如何泛化至真实世界
Q11:physical AI领域当前的研究现状是怎么样的?要攻克的几大问题是什么样的?
刘世隆:今年有一个非常大的范式转变:年初的时候,大家都觉得world-action model很好;年中Astra出来之后,越来越多的人倾向于Coding Agent本身就是一个比较好的Robot Control Policy,下一代physical AI的LLM就是现在的通用LLM。
但依然有两大瓶颈:
1.数据严重不足。我的博士导师朱军老师领导的团队叫TSAIL(statistical artificial intelligence lab),我也始终相信大模型依然是统计学习,就是从一个distribution到另一个distribution的mapping。既然如此,最大的问题就是数据,数据分布要cover足够多的领域、足够general,但目前各种意义上的机器人数据都比较匮乏。
2.机器人专有模型的意义。未来系统可能还是会分system one、system two。一个大脑去做planning,像LLM一样有非常强的世界理解;而小领域的快速反应,也要专门的action model去处理。这一部分就是机器人研究需要设计的地方。
Q12:世界模型领域研究现状是怎么样的?研究重点在哪里?
刘世隆:WAM和VLA没有本质区别,某种意义上就是换了预训练方式。我对world model的理解更像是传统的RL里的定义,world-model-based RL,给定一个state S和action A,能预测next state S'。
这样的话,它最大应用场景就是在一些非常niche的领域,下围棋也好、拧魔方也好,它可以做到比LM更好的效果。因为它可以完全模拟这个状态,有更好的搜索能力,搜索的效率更高。
Q13:CubeBench发现主流模型在长程任务上通过率极低,这种失败对评价世界模型有什么启示?
刘世隆:这可能正是世界模型能够起作用的地方。现在大模型再强,也没有在围棋上玩过AlphaGo,拧魔方上表现也不好。所以在这些非常小的闭合领域里,其实是比较适合用world model的。因为可以完全建模这些东西,再通过world model找到更好的解法。在未来,未必需要大模型包揽一切,非常多领域还是很需要world model的。
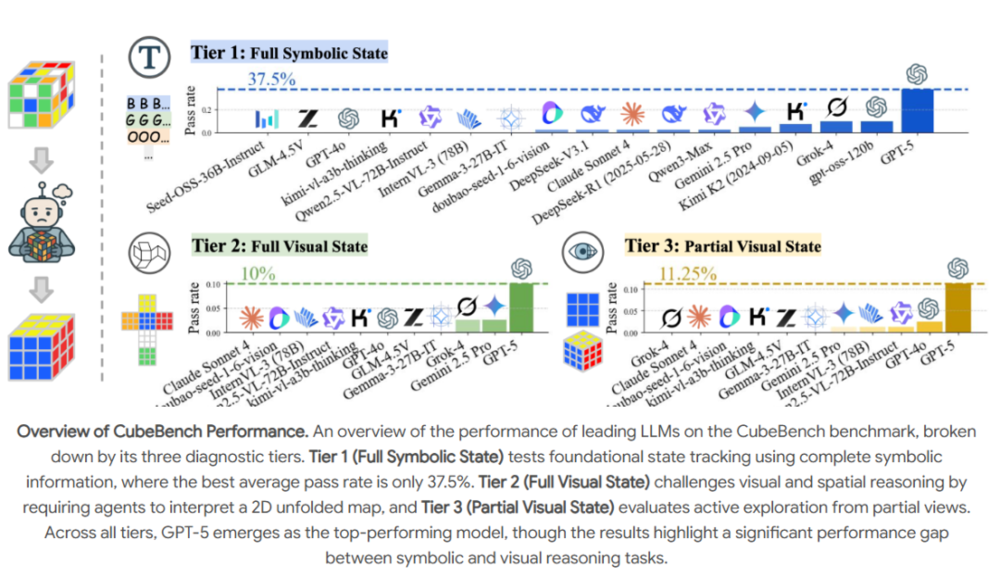
图注:CubeBench论文部分内容展示(https://cubebench.c7w.tech/)
Q14:什么样的门槛能证明“把智能带入物理世界”这一标准实现了?
刘世隆:大家都在说机器人的ChatGPT时刻,这肯定值得期待,而且这个时间也不会特别远了。现在的AI已经能帮我写邮件、做Deep Research,我希望有一天机器人在物理世界里真正帮我做事。我不觉得它一定要帮我做所有事情,只要它能在局部的物理空间里,帮我完成一系列事情,就已经是一个非常好的结果了。
05
Agents赋能科学发现:高容错红利与“老师傅的手感”
Q15:在Agents in scientific discovery领域,AI的优势与挑战是什么?
刘世隆:我觉得AI至少有两大优势:
1.极高的容错率。一些实际的工业落地场景要求99%的成功率,但AI过于有随机性,很难做到。而科学发现可以接受无数次的失败,只要成功一次就行,现在的AI比较契合这点。
2.高价值与Niche属性。对人类来说,scientific discovery是一个价值非常高的领域,它足够有意义、足够niche,并且现在数据点也很少,所以AI有巨大的发挥空间。
难点首先是数据不足。大量数据掌握在少数专家手里,而模型也需要适应大量的专有名词。现在Anthropic、OpenAI让各个学科的专家免费用AI,本质上就是为了蒸馏他们的知识、弥补这方面的数据分布不足。
借用一些生物实验的说法,更专用的挑战在于wet lab(在真实环境中操作的)。在大部分的dry lab,也就是virtual空间里,只要一个结果是可验证的,或者验证成本不太高的,有个benchmark,AI就可以刷上去。但是到了wet lab,物理世界中很多问题的答案不是确定的,很难verify。
第三点是,很多时候非常依赖于“老师傅的手感”,这些东西是说不清道不明的,很难被形式化地保存下来、再放到模型训练里。所谓的“老师傅的手感”,它既难量化,又很难描述,这个东西非常tricky。
06
坚定底层信念,把智能真正带入物理世界
Q16:总结来讲,怎么找到有价值的科研问题?
刘世隆:我现在找问题就是对一个东西有一个底层的信念。比如我相信深度学习是统计模型,从这个信念出发,我就可以判断对一个统计模型来说,什么事情是可行的,什么事情是不可行的。或者我对未来有一个判断,那我就沿这个方向走。只要走得比大家都快一点,那做研究就会是一个非常容易的事情。
早期我喜欢梳理paper的逻辑。但是现在paper实在太多了,信噪比有点过于低了,导致去梳理这些脉络不太容易。但之前梳理逻辑还是比较容易的,你能猜到他当时是怎么想到这个idea、怎么设计的实验、怎么去做的;甚至通过他的实验撰写,你都能猜出来他当时做实验可能遇到什么问题、踩了什么坑。
我觉得通过表面去推整个实验的深度流程,是一件很有意思的事情。Paper是一个Final Output,但是你要想办法从中推出CoT。
Q17:在整个研究链条中,哪些工作可以交给Agent做?如何判断它是否值得相信?
刘世隆:我会让它告诉我它做每个决策的原因,看它的思维链逻辑是不是靠谱的。如果是合理的,那我就相信它。判断一个Agent值不值得相信,和判断一个人值不值得相信一样,都是一件很难的事情。很多时候可能还是要有一些容错空间,不一定要百分之百相信,百分之九十九对就可以了。
当然,也取决于自己的需求。比如一个专家去问Agent一些问题,它的回答可能会有很多错误。但如果这个领域你完全不懂,它讲的东西大部分是对的,你就可以用。我觉得真实世界中大部分事情都不是百分之百对的,就要看这个东西对自己有没有用,能不能对自己有价值。
Q18:即将入职Columbia担任教职,对未来有怎样的期许?
刘世隆:我一直不是个喜欢做长期规划的人。按MBTI来说,我是个“P人”,习惯走一步看一步。但目前可以确定的是,我的大方向主要是Agent、Robotics和Agent for Science。我一直对自己抱有比较低的期待,这样的话,每一个成就都属于超出预期,我就会比较开心。我至少希望能做出一些有用的成果,如果做不出来也行,我不会给自己设定一个特别高的期待。
这个世界变化得特别快,我很难去预计未来这个世界、或者我会是什么样。还是走一步看一步,但我会尽最大的努力去做很多事情。不过,我有一个终极的梦想,就是bring the intelligence to physical world,我们希望能够把智能带到物理世界里。在这个目标之下,我会做尽可能多的尝试,并且坦然接受所有的结果。


